日本語音声から直接Actionを生成する小型モデル KoeAct-JP を作る ― 設計・学習からESP32-S3での実行まで

初めに

日本語の音声から、文字起こしを挟まずにAction JSONを生成する小型モデル「KoeAct-JP」を作りました。
音声付きの動画はこちらです。

youtube.com

合成音声とモデルの出力を使った動作イメージです。実機の推論時間を示す動画ではありません。

たとえば「顔を右に45度向けて」という音声から、次の操作を生成します。

[
  {
    "name": "look",
    "arguments": {
      "direction": "right",
      "degrees": 45
    }
  }
]

主な結果は、次の3つです。

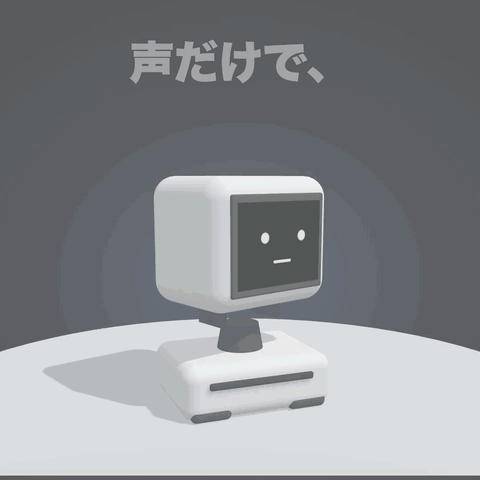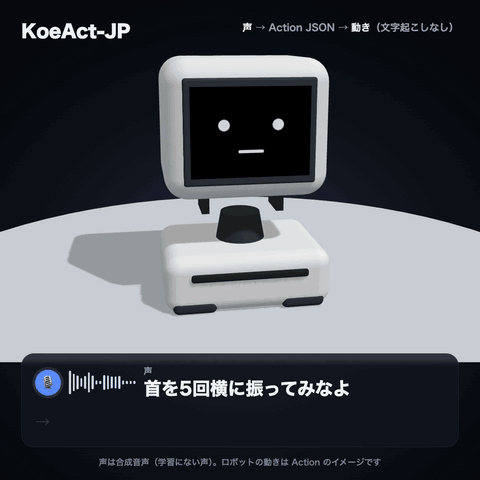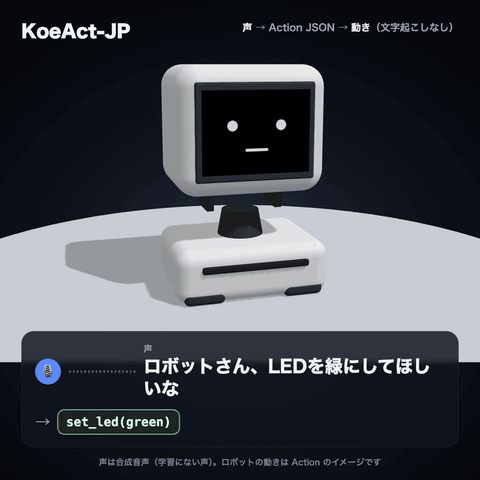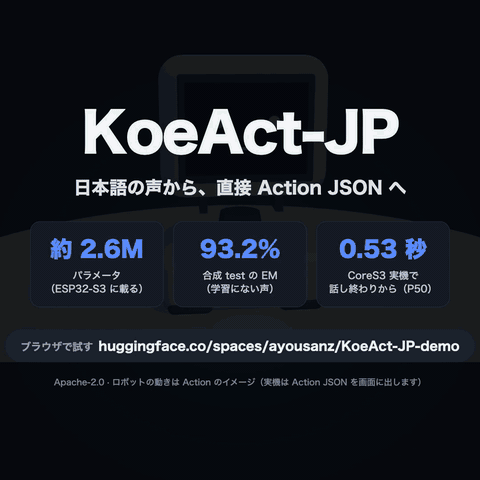
  • 約259万パラメータで音声からActionを生成。比較した文字起こし経由の構成は、約520万パラメータでした。
  • 合成音声でのAction完全一致率(EM)は93.2%。比較相手は83.6%で、いずれも5回の学習の平均です。
  • CoreS3で録音終了後の待ち時間を中央値0.53秒に短縮。端末内でActionのピース列を計算し終えるまでの実測値です。

依頼音声の精度は合成音声で評価しています。実際の話者による精度評価はまだ行っておらず、会話や歌に対する誤発火も課題として残っています。

公開モデルは以下です。

huggingface.co

ブラウザデモでは、話しかけた音声からActionを生成し、その内容に合わせて3Dのロボットが動きます。

huggingface.co

この記事では、音声から直接Actionを出す仕組みと、学習中に分かったこと、実機で待ち時間を短くした工夫を紹介します。

開発の背景と目的

以前、ESP32-S3で動く日本語音声認識モデル「Ralomi」を作りました。

ayousanz.hatenadiary.jp

日本語テキストからAction JSONを生成する「JapaneseTinyAgentLM」もあるので、この2つをつなげば音声操作ができます。

ただ、ロボットに「右を見て」と伝えるために、いったん全文を文字列にする必要があるのかが気になりました。操作名と引数だけが必要なら、音声の特徴から直接取り出すことで、モデルを小さくし、応答も速くできるかもしれません。

そこで、文字起こしを経由するカスケード方式と、音声特徴から直接Actionを生成する構成を比較しました。

カスケード:
音声 → Ralomi → かなの文字起こし → JapaneseTinyAgentLM-kana → Action

KoeAct-JP:
音声 → Ralomiの音声特徴 → 小型Actionデコーダ → Action

評価で重視するのは、最終的な操作が正しいか、依頼していない場面で動いてしまわないかです。

対応する操作

顔を向ける look、体を回す turn、うなずく nod、首を振る shake、お辞儀する bow、表情・LED・音量・明るさの変更など、固定の11ツールに対応しています。1発話で生成するActionは最大2つです。

否定や対象外の発話では、何もしないことを表す [] を正解とします。たとえば「やっぱりライトは消さないで」なら [] です。

扱える操作と引数は学習時に固定しています。推論時にツール定義を渡して、新しい操作を追加することはできません。

KoeAct-JPのモデル構成

約205万パラメータのRalomiに、約54万パラメータのActionデコーダを組み合わせています。Ralomiが持つ音声特徴を、小さなデコーダでActionへ変換する構成です。
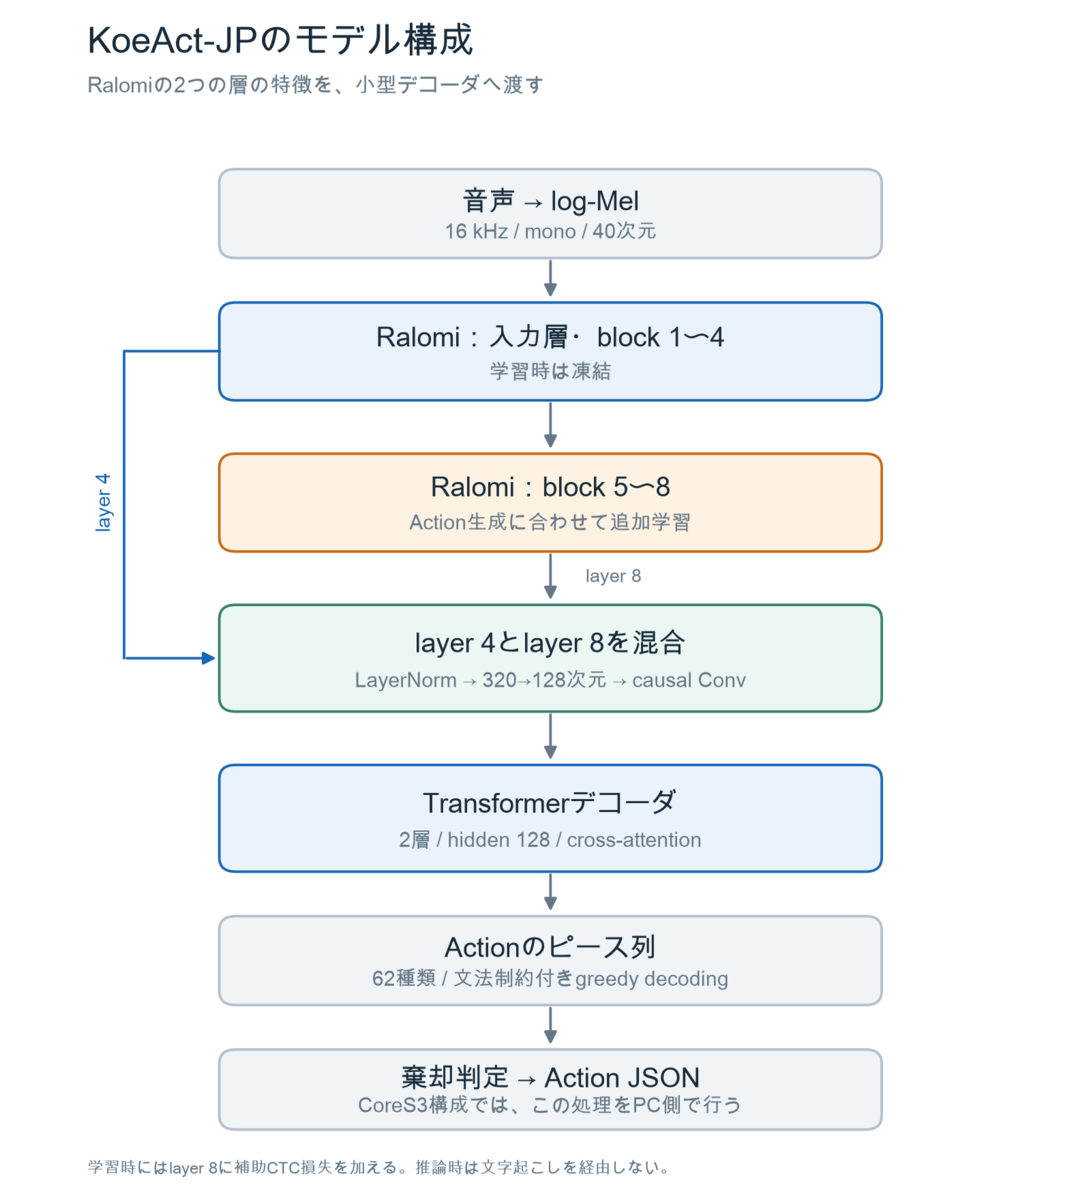
図1:Ralomiのlayer 4とlayer 8の特徴からActionを生成する構成。CoreS3では、最後の棄却判定とJSON化をPC側で行います。

項目 構成
音声エンコーダ Ralomi、8層のcausal DFSMN、約2.05M
利用する特徴 layer 4と、追加学習したlayer 8
Actionデコーダ 2層のTransformerデコーダ、約0.54M
デコーダの次元 hidden size 128、4 heads、FFN size 384
出力 62種類のピース、最大24ステップ
モデル全体 約2.59Mパラメータ

音声特徴からのAction生成

Ralomiのlayer 4とlayer 8の特徴を、学習した重みで混合します。それを320次元から128次元へ射影し、causalな畳み込みを通して、デコーダのcross-attentionで参照するmemoryにします。

最終構成では、入力層とblock 1〜4を凍結し、block 5〜8をAction生成に合わせて追加学習しました。学習時には、layer 8から日本語の読みを予測する補助CTC損失も加えています。

学習設定:補助CTC損失の重みは0.3。追加学習するRalomi側の学習率は、デコーダ側の0.1倍です。

推論時には、これらの特徴をそのままAction生成に使います。CTCで文字列を復号して、後段へ渡す処理は行いません。

文法制約付きデコーディング

デコーダは、JSONのまとまりや引数の値を、固定の「ピース」として順番に出します。冒頭の例なら、look の操作と引数のキーを含む部分、right、数字の 4 と 5、閉じ括弧などです。

生成中は、そこまでのピース列に続けられる候補を文法で絞り、その中で最も確率の高いものを選びます。これにより、スキーマに合うJSONを生成できます。

ただし、JSONの形式が合っていても、操作の内容まで正しいとは限りません。音声の意味を取り違えれば、操作名や引数を誤ることがあります。

スコアによる棄却

依頼していない会話や環境音での動作を減らすため、出力を [] に切り替える処理を入れました。判定には、最初の生成ステップでの [] の確率を使います。

p_act = 1 − P(最初のピースが [])

p_act が閾値を下回ったら、Actionを出さずに [] を返します。公開モデルの閾値は0.97です。このスコアが高くても、選んだ操作や引数まで正しいとは限りません。

閾値の決め方:validationの対象外発話に対する誤発火率が2%以下になるよう、モデルごとに固定しました。

合成音声による学習データ

日本語テキストとAction JSONのペアを用意し、Irodori-TTS VoiceDesignで音声化しました。単一の操作だけでなく、数値指定、複数Action、否定、言い直しも含めています。

テキストにはJapaneseTinyAgentLM-Action-Synthと数値・否定のテンプレートを使い、対象外の発話にはAmazon MASSIVEの日本語データなどを使いました。

項目 最終構成の学習データ
学習用テキスト 54,500文
合成音声の声 120種類
学習用の音声コピー 107,964件。cleanと増強したコピーの合計

合成音声は品質チェックを通し、そのままの音声と、雑音・残響などを加えた音声を用意しました。この記事では、雑音などの増強を加えていない条件をcleanと呼びます。

さらに、操作の依頼ではない話し声や雑音も負例として学習に加えました。これらには、ReazonSpeechやOpenSLR SLR28由来の実録音を使っています。

学習・評価データの分離

学習に使った文や声を覚えているだけにならないよう、validation・testには学習に使っていないテキストと声を割り当てました。

数値についても、角度の25・37・75・105・135・165などを学習から外しています。これらは評価だけに使い、学習にない値を生成できるかを確認しました。

前処理の影響

ブラウザデモを作る際、同じモデルでも、入力の前処理を省くとEMが約4.5ポイント下がることが分かりました。前処理をそろえると、記録した値に近い結果へ戻ります。

行っているのは、音量を−23 dBFSにそろえ、先頭に0.5秒、末尾に0.3秒の無音を加える処理です。clean条件でも、この処理は入れています。

先頭からすぐに発話が始まると、Ralomiが最初の語を取りこぼしやすいことが原因と考えられます。公開runtimeもv0.1.1から、学習・評価と同じ前処理を標準で行うようにしました。

比較に使ったデータ:合成validation。前処理を省いた場合と、そろえた場合を同じ公開モデルで比較しました。

声の数と追加学習の効果

最初はRalomiを凍結し、Actionデコーダだけを学習しました。Actionは出せるようになりましたが、初期の合成testでは、cleanの単一ActionのEMが77.8%で、目標の80%に届きませんでした。

改善のため、学習用テキストを増やし、声の数とRalomiの追加学習を比較しました。ここからの構成選択は、データを増やした条件で、合成validationを使って行っています。

声の数による精度比較

声を5種類から120種類に増やしても、EMはほとんど変わりませんでした。 5・20・60・120種類を比較しましたが、全体EMは88.0〜88.1%に収まっています。

評価条件:Ralomiを凍結した構成、合成validation、棄却前。乱数seedを変えた3回の学習の平均です。

凍結したRalomiの特徴が、合成音声の声の違いをある程度吸収している可能性があります。実際の話者でも同じかは未確認ですが、今回の条件では、声を増やすだけでは大きな改善につながりませんでした。

最終構成には、比較した範囲で声の多様性が最も大きい120声を使いました。

上位ブロックの追加学習

一方、Ralomiの上位ブロックを追加学習すると、精度が改善しました。 同じ120声条件のデータで、最後の2ブロックを学習する構成と、4ブロックを学習する構成を比較した結果です。

構成 全体EM 増強条件のEM
Ralomiを凍結 88.0% 84.1%
最後の2ブロックを追加学習 92.2% 89.3%
最後の4ブロックを追加学習 92.9% 90.0%

評価条件:同じ合成validation、棄却前、3回の学習の平均。

最後の4ブロックを学習した構成は、凍結した構成より全体EMが4.9ポイント高く、特に増強条件での伸びが大きくなりました。

この結果から、最終構成を「120声、block 5〜8を追加学習」に決めました。その後、構成選択時とは別の乱数seedで5回学習し、validationで棄却閾値を固定して最終比較を行いました。公開する重みも、testを見る前にvalidationのEMで選んでいます。

カスケード方式との性能比較

比較相手は、Ralomiのかなの文字起こしをJapaneseTinyAgentLM-kanaへ渡す構成です。後段のモデルも、拡張した学習データに対応するRalomiの認識結果で学習し直しました。

この節の精度と誤発火の比較には、乱数seedを変えて5回学習した平均を使います。両方式で棄却スコアと閾値の選び方が異なるため、棄却処理を含めたシステム全体として比べています。

合成音声での精度と雑音耐性

合成test全体のEMは、KoeAct-JPが93.2%、カスケードが83.6%でした。 特に、雑音が強い条件で差が開きました。
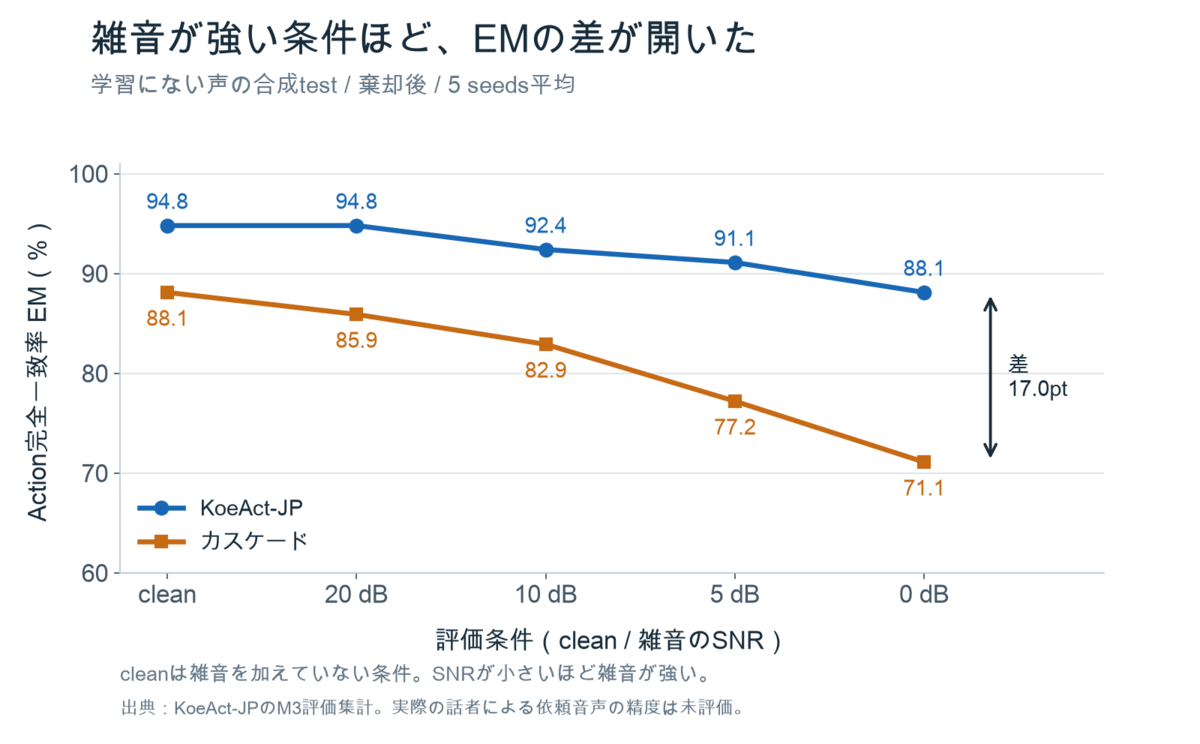
図2:雑音の強さごとのEM。学習にない声の合成音声で評価した、棄却後・5回の学習の平均値です。

評価には、3,425文のそれぞれにcleanと雑音ありの音声を用意した、計6,850件を使いました。EMは操作名・引数・複数Actionの順序まで一致した割合で、JSONの空白やキー順は正規化しています。

全体の差は、丸め前の値で9.5ポイントです。SNR 0 dBでは17ポイントの差になり、学習にない数値だけのカテゴリでも、89.6%対63.5%と差がありました。

全体EMの差の95%区間:+8.7〜+10.4ポイント。テキスト単位の対応bootstrapで計算。

ただし、すべての条件で同じように改善したわけではありません。cleanの複数Actionと言い直しは、両方式でほぼ同じでした。また、KoeAct-JPではエンコーダも追加学習しているため、改善の原因を文字起こしの省略だけに分けることはできません。

非依頼音声での誤発火

否定された操作を出してしまう誤作動率は、KoeAct-JPが0.05%、カスケードが0.60%でした。一方、操作を依頼していない音声での誤発火は、KoeAct-JPのほうが多くなりました。

音声 KoeAct-JP カスケード
全体の誤発火 1.57回/時 1.38回/時
人の話し声・歌のカテゴリ 4.44回/時 4.28回/時

測定条件:MUSANとFSD50Kの収録音声14.02時間をVADで区切り、Actionが出た回数を元の音声の時間で割って集計。値は5回の学習の平均です。

「誤発火をカスケード以下にする」という事前の基準には届きませんでした。依頼の音声では正しくActionを出せても、会話や歌を操作として拾ってしまう問題が残っています。実際に使う際は、ボタンやウェイクワードで入力を限定する工夫が必要です。

評価条件と制限

依頼音声の正解率は、すべて合成音声で評価しています。実際の話者や、マイクとの距離・部屋の響きによって、どの程度精度が変わるかはまだ測っていません。

評価と公開モデルについては、次の点も補足しておきます。

  • モデルの選択:最終構成と閾値はvalidationで選び、最終比較の評価方法は予測を作る前に固定しました。ただし、合成testは初期の別構成の評価にも一度使っています。
  • 公開する重み:5モデルのうちseed 14です。単体のtest EMは93.6%、非依頼音声での誤発火は1.07回/時でした。上の比較に使った5回の平均とは区別しています。

seedごとの結果やカテゴリ別の詳細は、公開モデルのModel Cardにまとめています。

PCでの推論時間

PCでは、KoeAct-JPの推論時間の中央値が7.1 ms、カスケードが16.6 msでした。約2.3倍の差はありますが、どちらも音声長の1%以下の時間で処理できています。

計測条件:Apple M1のCPU、1スレッド、合成validationの200発話、平均4.75秒。音声全体を受け取ってからActionを出すまでを計測し、録音時間は含みません。入力は一律15秒にpaddingせず、実際の長さで処理しています。

待ち時間の差が大きく効いたのは、CoreS3側でした。

ESP32-S3への実装と高速化

実機にはM5Stack CoreS3を使いました。RalomiはESP-DL向けにW16A16へ量子化し、ActionデコーダはCで実装しています。

現在は、CoreS3で音声からActionのピース列まで計算し、接続したPCで棄却とJSON化を行います。

CoreS3:音声 → 特徴抽出 → Ralomi → デコーダ → ピースID列とp_act
PC    :p_actによる棄却 → ピース列をJSONへ変換

モーターを動かす処理は、現在のファームウェアには含めていません。

最初に、float32のデコーダと1秒単位の処理で測ってみると、録音終了後に中央値2.52秒かかりました。この待ち時間を短くするため、同じ学習済みモデルに対して3つの変更を加えました。

  1. デコーダの行列の重みをint16にする:行ごとのスケールを持たせ、float32より重みの読み出し量を減らす
  2. デコーダのencodeを録音中に進める:音声特徴をmemoryへ変換する処理を、区間ごとに終えておく
  3. Ralomiを0.4秒単位にする:DFSMNの状態を引き継ぎ、録音終了後に残る最後の区間を短くする

録音中に特徴抽出・Ralomi・デコーダのencodeまで進めておけば、録音後に待つのは、最後に残った区間とピース生成の処理だけになります。

区間を短くすると呼び出し回数は増えるので、計算の総量が減るとは限りません。今回は、録音が終わった後の待ち時間を短くすることを重視しました。
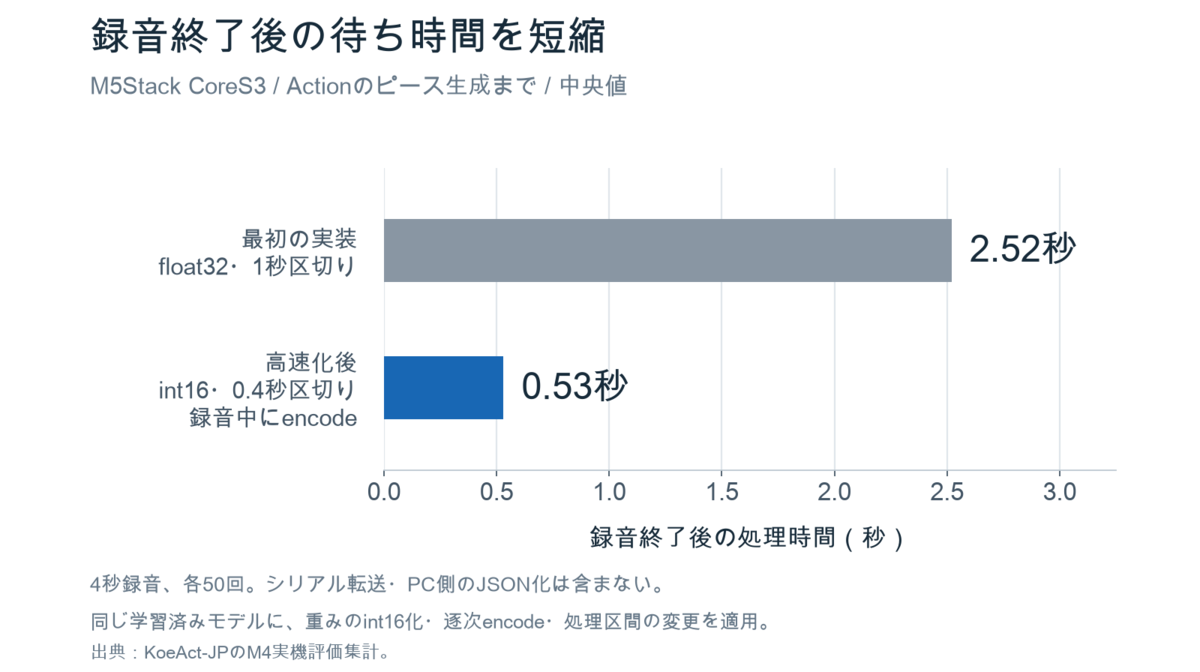
図3:同じ学習済みモデルに、重みのint16化・録音中のencode・0.4秒への区切り変更を適用した結果です。

この変更で、録音終了後の待ち時間は中央値0.53秒になりました。 実機とPCのActionも、600件中597件で一致しました。

項目 結果
録音終了からピース生成まで、P50/P95 0.53秒/0.79秒
PCとのActionの一致 99.5%:597/600件
動作待機中の内部RAM空き最小値 約56 KB
デコーダによるPSRAMの追加使用量 約1.11 MB
Ralomiのモデル/デコーダの重み 4.81 MB/1.13 MB

遅延の測定条件:Macのスピーカーから合成音声を再生し、CoreS3のマイクで4秒録音する操作を50回実施。4秒の録音終了から、端末内のピース計算完了までを計測しています。シリアル転送・PC側のJSON化は含みません。

録音後に残る処理の中央値は、Ralomiの最後の区間が約0.26秒、最後のencodeが約0.03秒、ピース生成が約0.24秒でした。

PCとの一致率は、合成validationの600発話を実機に送り、同じ入力で照合した値です。また、内部RAMの空きは動作待機中の値で、モデル読み込み中には一時的にほぼなくなります。機能を追加する際は、起動時のメモリ使用量も確認する必要があります。

カスケードとの遅延比較

カスケード方式とも、同じCoreS3で比較しました。

構成 録音終了後の遅延P50 条件
KoeAct-JP 0.53秒 実測、0.4秒区切り
カスケード 1.54秒 実測、1秒区切り
カスケード 1.30〜1.44秒 見積もり、0.4秒区切り相当

カスケードの0.4秒区切り版は実測していません。表の見積もりは、KoeAct-JPで測ったRalomiの最後の区間の時間に、JapaneseTinyAgentLM-kanaの実測時間を足したものです。

この見積もりと比べると、KoeAct-JPの待ち時間は約2.5〜2.7分の1です。主な差は後段の処理にあり、KoeAct-JPのピース生成が約0.24秒なのに対し、JapaneseTinyAgentLM-kanaは約1.0〜1.2秒でした。

公開モデルの実行方法

PCでの実行方法

以下は、uvを使うmacOS・Linux向けの手順です。前処理が標準で入るv0.1.1を取得します。

uvx --from huggingface-hub hf download ayousanz/KoeAct-JP \
  --revision v0.1.1 --local-dir koeact-jp

cd koeact-jp
uv venv --python 3.13
uv pip install -r code/requirements.txt

WAVファイルを渡す場合は、次のコマンドでActionを生成できます。

PYTHONPATH=code .venv/bin/python -m koeact.runtime \
  --model . a.wav

マイクを使う場合は sounddevice を追加して、--mic を指定します。Enterで録音を開始し、もう一度Enterで停止します。

uv pip install sounddevice

PYTHONPATH=code .venv/bin/python -m koeact.runtime \
  --model . --mic

入力の前処理は標準で有効です。モデルが扱う長さは前処理後15秒までで、先頭に加える0.5秒の無音を含むため、元の音声の約14.5秒より後は使われません。

CoreS3での実行方法

公開モデルの cores3/ に、変換済みモデル、デコーダの重み、ファームウェアのソースを置いています。ESP-IDF v5.5.5の環境で、取得したモデルのフォルダから以下を実行します。

cd cores3/firmware/e05

idf.py \
  -DRALOMI_ESPDL="$PWD/../../ralomi_e13_stream40.espdl" \
  -DA2_WEIGHTS="$PWD/../../a2_weights.bin" \
  build

idf.py -p YOUR_SERIAL_PORT flash

YOUR_SERIAL_PORT はCoreS3の接続先に置き換えてください。書き込み後、画面をタッチすると4秒録音し、録音しながら推論します。

PCでピース列を受け取り、JSONへ変換するには、次のコマンドを使います。

cd ../../..
uv pip install pyserial

PYTHONPATH=code .venv/bin/python -m koeact.runtime \
  --model . --serial YOUR_SERIAL_PORT

まとめと今後の課題

約259万パラメータのモデルで、日本語音声から直接Actionを生成し、CoreS3でピース列を出力するところまで動かしました。

学習では、声を増やすだけでは精度がほとんど変わらず、Ralomiの上位層を追加学習することで改善しました。実機では、録音中に計算を進めることで、録音後の待ち時間を短くできました。

一方、依頼ではない音声での誤発火は、カスケード以下という基準に届いていません。実話者での精度評価と誤発火の改善、端末内での棄却・JSON化、ロボットの動作との接続が、今後の課題です。

関連モデルとデータ

KoeAct-JPの重み・推論コード・評価の詳細は、冒頭の公開モデルにあります。ベースにしたモデルとテキストデータは以下です。
huggingface.co

github.com

huggingface.co

ESP32-S3で動く日本語音声認識モデル Ralomi を作る ― 学習からM5Stack CoreS3での実行まで

初めに

今回は、ESP32-S3で日本語の音声認識を動かすために、約205万パラメータのモデル「Ralomi」を作り、学習から16bit量子化、M5Stack CoreS3でのマイク入力と画面表示まで試しました。

CoreS3の画面をタッチすると、4秒の録音中に音声を約1秒ずつ処理し、録音終了から約0.5秒で認識処理を終えてひらがなの結果を表示します。PCやネットワークにつながず、バッテリーでも動きます。

ひらがなは出るようになりましたが、短い文でも文末が抜けるなど、誤認識は残っています。今回はモデルの構成と学習、実機で動かすための変換、実際の認識結果をまとめます。

公開モデルとブラウザデモは以下です。まずはデモから認識を試せます。

huggingface.co

huggingface.co

CoreS3用のモデルとファームウェアは、モデル内のesp32s3フォルダに置いています。

作ろうと思った背景

以前、日本語の音声合成(sanoTTS-jp)をESP32-S3で動かす取り組みをしていました。

github.com

テキストから音声を作れるなら、逆方向の音声からテキストへの変換も、モデルを十分に小さくすれば動かせるのではないかと思いました。

認識できる言葉をコマンドの一覧に限定せず、話した日本語の読みを文字列として取り出したいと考えました。まずは、音声の特徴抽出とモデルの推論を端末の中で完結させるところを目指しています。

今回使ったCoreS3のメモリ構成と用途は以下です。

  • flash:16MB(アプリとモデルの保存用)
  • PSRAM:8MB(内部RAMとあわせて、推論中のデータ・録音音声・特徴量を保持)
  • 重みのファイルサイズだけでなく、実行時のメモリ使用量も考慮

今回は、ひらがなを出力する約2Mのモデルに構成を固定して、学習と実機への組み込みを進めました。

作ったものと開発環境

公開したRalomi v1.0.0の構成は以下です。

項目 内容
パラメータ数 2,049,181(約205万)
音響モデル 8層のcausal DFSMN+CTC
音声入力 16kHz・モノラル、0.1〜15秒。ONNX本体への入力はlog-Mel特徴量
特徴量 40次元log-Mel、窓幅25ms・移動幅10ms
出力 モーラtokenを復号した正規化ひらがな
復号 greedy decoding。言語モデルやbeam searchは使用しない
公開モデル ReazonSpeech約10,000時間でスクラッチ学習した990k step版
PC向け FP32 ONNX、約8.3MB
CoreS3向け W16A16のESP-DLモデル、約4.3MB

学習にはVast.ai上のRTX 4090を2枚使い、PyTorchのDDPで分散学習しました。Pythonの環境管理にはuvを使っています。

実機への変換と確認はWindows 11で行い、主に以下のツールを使いました。

用途 ツール・構成
量子化 ESP-PPQ 1.3.11、Python 3.12.13、PyTorch 2.8.0
実機 M5Stack CoreS3(ESP32-S3、flash 16MB、PSRAM 8MB)
ファームウェアのビルド ESP-IDF v5.5.5
ニューラルネットワークの実行 ESP-DL 3.3.13
特徴抽出のFFT ESP-DSP 1.8.2
マイク・画面制御 M5Unified 0.2.17、M5GFX 0.2.23
書き込み esptool 5.6.0

量子化用の環境は、通常の学習・評価用とは分けました。

Ralomiのアーキテクチャ

全体の処理は以下です。

16kHzの音声
    ↓
40次元log-Mel特徴量(10msごと)
    ↓
4フレームをまとめて線形変換
    ↓
causal DFSMN × 8層(40msごとの系列)
    ↓
157クラスの出力
    ↓
CTCのgreedy decoding
    ↓
正規化ひらがな

音声から特徴量を作る

音声を16kHz・モノラルにそろえ、25msの窓を10msずつ動かし、FFTサイズ512で40次元のlog-Mel特徴量を作ります。

続いて、隣接する4フレームを連結して160次元からhidden sizeの320次元へ線形変換し、DFSMNが処理する系列長を約4分の1にします。

1秒あたり約100フレームの特徴量を、約25ステップとして処理する形です。

DFSMNで過去の音を参照する

DFSMNは、過去の表現をメモリとして持つFeedforward Sequential Memory Networkを深く積み重ねたもので、保持した表現を現在の表現へ足し合わせます。元の論文では、メモリブロック間のskip connectionなどが提案されています。

Ralomiでは、その考え方を使った残差ブロックを8層積み重ねています。各ブロックはhidden size 320、projection size 216、過去のメモリ長8ステップです。

ブロック内では、おおまかに次の処理を行います。

入力(320次元)
    ↓
線形変換+ReLU
    ↓
216次元へ射影
    ↓
現在の表現+過去8ステップの表現を重み付きで加算
    ↓
320次元へ戻して入力と残差加算
    ↓
LayerNorm+ReLU

今回の構成は、各ブロックで未来のフレームを参照しないcausalなモデルで、DFSMN部分は各ブロックが直前8ステップ分の表現を持てば次の区間を処理できます。モデル全体が参照する過去が8ステップだけ、という意味ではなく、8層それぞれにメモリがあります。

このメモリを次の区間へ引き継ぐことで、後述する1秒ずつの推論ができます。

CTCで文字列へ変換する

音声と文字では長さが違い、どの時刻がどの文字に対応するかも最初からは分かりません。そこで、学習にはCTCを使いました。

モデルは各ステップで、モーラtokenやblankのスコアを出します。推論では最もスコアが高いtokenを選び、連続する同じtokenをまとめてからblankを取り除きます。同じtokenでも、途中にblankを挟んだものは別の出力として残します。

復号にはこのgreedy方式を使い、別の言語モデルによる文章の補正や、複数候補を探索するbeam searchは入れていません。

日本語をモーラで認識する

出力単位にはモーラを使い、「きゃ」「しゅ」「ふぁ」などをそれぞれ1 tokenとして扱います。「ん」「っ」「ー」も独立したtokenにして、blankとunknownを含めて157クラスです。

ひらがなを1文字ずつ出す場合より、拗音などの教師系列を短くできます。また、漢字を含む表記を直接出すより語彙を小さくできるので、出力層のサイズも抑えられます。

学習用テキストは読みへ正規化してから、最長一致でモーラに分割しました。たとえば、次のようになります。

元の文:今日はいい天気ですね
読み :きょーわいいてんきですね
token :きょ / ー / わ / い / い / て / ん / き / で / す / ね

そのため、「こんにちは」が「こんにちわ」、「今日は」が「きょーわ」と出るのは今回の出力仕様です。漢字・句読点への変換は行っていません。

なお、評価に使うKana CERはモーラ単位ではなく、tokenをつないだ後のひらがなの文字列で計算しています。「きょ」は1 tokenですが、文字誤り率では「き」と「ょ」の2文字です。

ReazonSpeechで学習する

モデルはランダムな重みから始め、optimizerも新しく初期化して、ReazonSpeech v2から準備した約10,000時間、6,556,810件の音声でスクラッチ学習しました。

音声の前処理、読みへの変換、モーラtoken化を行い、固定した1,319件のValidationで途中の精度を確認しました。未知のtokenを含むデータなどは準備時に検査しています。

主な学習設定は以下です。

項目 設定
GPU RTX 4090 × 2、DDP
global batch size 128
optimizer AdamW
基準学習率 0.0003
warmup 5,000 step
学習量 最初に1,000,000 step。その後300,000 step追加
Validation 10,000 stepごと
CTC loss CPUで計算、token-mean
補助損失 4層目にもCTCを適用、重み0.3
ノイズ付加 確率0.5、SNR 0・5・10・15・20dB

モデル本体はGPUで学習し、CTC損失の計算はCPUへ分けました。途中で学習が中断しても続けられるように、重みだけでなくoptimizerや乱数の状態なども保存しています。

学習途中の精度

最初の1M stepのValidation Kana CERは以下でした。CERは正解文字列に対する置換・削除・挿入の割合で、低いほどよい値です。

step Validation Kana CER
10,000 40.45%
100,000 26.22%
300,000 23.85%
500,000 22.64%
990,000 21.03%
1,000,000 21.19%

最初の1M stepの中でCERが最も低かった990kのチェックポイントを公開しています。

さらに300k stepを追加して累計1.3Mまで学習しましたが、改善は小さく、別の開発用評価では悪化しました。

モデル Validation Kana CER Clean開発診断 Kana CER
公開した990k版 21.03% 25.28%
追加学習中のbest(1.23M) 21.00% 25.89%

Clean開発診断は、開発中に参照した316件・8,700文字の評価で、独立した最終testではありません。追加学習ではValidationがわずかによくなった一方、Cleanでは誤りが増えました。

ESP32-S3で動かすための変換と工夫

学習したモデルをFP32のONNXに書き出すと、PC向けのファイルは約8.3MBになりました。

実機ではESP-DLを使うため、ONNXからESP-PPQで量子化し、.espdl形式へ変換します。ESP-DLはEspressifのデバイス向けの推論ライブラリです。

PyTorchの学習済みモデル
    ↓
FP32 ONNX
    ↓
ESP-PPQで量子化
    ↓
ESP-DL用 .espdl
    ↓
CoreS3のファームウェアから実行

変換後のモデルを確認すると、精度や実機での出力に問題がありました。

8bitでは精度が落ちた

ESP-PPQのシミュレーションでW8A8・W8A16を試しましたが、今回の変換条件ではどちらもFP32より精度が下がりました。Common Voiceの全4,483件では、FP32のCER 18.74%に対し、W8A8は61.46%、W8A16は22.85%でした。W8A8は実機でも一部の音声で確認しましたが、W8A16の数値はシミュレーションでの結果です。

今回のモデルと変換条件では、重みと活性の両方を16bitにするW16A16を採用しました。

Wはweight(重み)、Aはactivation(活性)を表します。W16A16は整数の16bit量子化で、浮動小数点のFP16とは別です。

キャリブレーションにはReazonSpeech tinyの982件を使いました。配布している1秒処理版のモデルは4,334,768 bytes、約4.3MBです。

シミュレーションと実機で結果が違った

最初の16bitへの変換では、PC上の量子化シミュレーションと実機の結果がずれ、Common Voiceの300件で実機のCERがFP32より約0.74ポイント悪くなっていました。

層ごとの出力を調べると、INT16のReLUをLUTに変換した部分で差が大きくなっていました。ESP-PPQ 1.3.11の書き出しと、ESP-DL 3.3.13の実行時で、LUTによる近似とシミュレーションの扱いがそろっていませんでした。

int16_lut_step=-1としてINT16 ReLUのLUT化を無効にすると、実機での認識精度はFP32に近いところまで戻りました。

ただし、logitまで完全一致したわけではありません。参照入力で層ごとに調べると、LayerNormalizationの丸めによる差が残り、最終logitの差は最大15 LSBでした。LSBは量子化後の整数値の最小刻みです。

配布版でも、起動時の参照値チェックはTEST FAILと表示されます。この不一致は残っているため、音声を認識させたときのCERもFP32と比較して判断しました。

録音しながら1秒ずつ認識する

最初の実機用モデルは最大15秒の特徴量をまとめて処理する形で、短い音声でも15秒分を計算するため、モデル推論に約7.8秒かかっていました。

そこで、100フレーム、約1秒ずつ処理するモデルへ変更しました。DFSMNが過去だけを参照するので、各層の直前8ステップ分の状態を次へ渡せば続きが計算できます。

最初の100フレーム+ゼロ初期状態
    ↓ モデル
認識スコア+各層の次の状態
    ↓ 状態を引き継ぐ
次の100フレーム
    ↓ モデル
認識スコア+各層の次の状態
    ↓
発話の最後まで繰り返す

ここでは、評価済みの.espdlをもう一度量子化するのではなく、同じ重みと量子化の設定を保持して、入力の長さと状態の入出力を変更しました。

実機では、各区間のフレームごとのargmaxをつなぎ、発話の最後にまとめてCTC復号しています。区間ごとに独立して復号しないので、境目で続いている同じtokenもまとめられます。

分割前後を比較した結果は以下です。

比較 結果
PCのFP32 ONNX、9,551件 有効フレームのlogit・argmax・復号token列が一致
実機のW16A16、600件 15秒一括版と1秒処理版の復号token列が一致

マイク入力では、次の区間を録音している間に、取得済みの音声から特徴量を作って推論します。25msの特徴抽出窓に必要なサンプルまで録音するように区切りを調整し、最後に計算が大きく残らないようにしました。

現在のファームウェアは画面タッチで4秒録音して認識結果を表示する構成で、録音終了から認識処理の完了までは約495msでした。自動で話し終わりを判断するVADや、無制限の連続書き起こしは入れていません。

M5Stack CoreS3で動かしてみる

ここからは配布済みのファイルを使うので、モデルの学習やESP-IDFでのビルドは不要です。動作を確認したボードはM5Stack CoreS3です。

書き込み用ファイルを取得する

uvを導入した環境で、以下を実行します。

uvx --from huggingface-hub hf download ayousanz/ralomi esp32s3/ralomi_cores3_w16a16_stream100.bin --local-dir .

esp32s3フォルダへ、bootloader・パーティション表・アプリ・モデルをまとめた約6.4MBの書き込み用ファイルが保存されます。

ブラウザから取得する場合は、以下を使ってください。

CoreS3用の書き込みファイル

CoreS3へ書き込む

CoreS3をUSB-CでPCにつなぎ、接続先のポートを確認します。以下はWindowsでCOM3に接続した例なので、実際のポート番号に置き換えてください。

書き込むと元のアプリやデータが上書きされるので、元へ戻したい場合は先にflash全体を保存します。

uvx --from esptool==5.6.0 esptool --chip esp32s3 --port COM3 read-flash 0 ALL backup.bin

結合済みのファイルを、アドレス0x0に書き込みます。

uvx --from esptool==5.6.0 esptool --chip esp32s3 --port COM3 --baud 921600 write-flash 0x0 esp32s3/ralomi_cores3_w16a16_stream100.bin

手元では約30秒で終わりました。ポートが見つからない、または書き込みが始まらない場合は、リセットボタンを緑のLEDが点くまで長押ししてダウンロードモードにします。書き込み後はリセットボタンを一度押してください。

起動して約10秒で「画面をタッチすると4秒録音して認識します」と表示されます。画面をタッチし、「録音中…」の間に話すと結果が出ます。

モデルとファームウェアは本体に入っているので、書き込み後はUSBを外してバッテリーでも認識できます。

ファームウェアを変更したい場合

ソースもHugging Faceに置いています。ESP-IDF v5.5.5の環境を用意し、その環境のターミナルで以下を実行します。

uvx --from huggingface-hub hf download ayousanz/ralomi --include "esp32s3/*" --local-dir ralomi
cd ralomi/esp32s3/firmware
idf.py set-target esp32s3
idf.py build
idf.py -p COM3 flash

モデルとソースの配置をダウンロード時のままにしておくと、アプリと一緒に../ralomi_w16a16_stream100.espdlも書き込まれます。

実機での認識結果・速度・メモリ

マイクで話してみる

最終的な1秒処理版でCoreS3のマイクに向かって話し、同じ録音をPCのFP32 ONNXでも認識させました。

話した内容 CoreS3の出力 PCのFP32出力
こんにちは こんにちわ こんにちわ
今日はいい天気ですね きょーわいいてんきです きょーわいいてんきです
明日の天気は何ですか あしたのてんきわなんですか あしたのてんきわなんですか

3回ともCoreS3とPCは同じ出力でしたが、2つ目はどちらも文末の「ね」が抜けています。この例では、元のFP32モデルにも同じ誤りがあります。

これは動作例で、3発話から一般的な認識精度を見積もれるわけではありません。

FP32と実機の精度を比較する

Common Voice 8.0日本語testとReazonSpeech testからそれぞれ300件を選び、同じ音声を実機とPCで認識させて比較しました。

評価データ CoreS3 W16A16 Kana CER PC FP32 Kana CER 実機−PCの差(95%区間)
Common Voice 8.0、300件 19.43% 19.43% +0.00pt(−0.09〜+0.11)
ReazonSpeech、300件 22.51% 22.54% −0.04pt(−0.10〜+0.02)

95%区間は、同じ発話を対にしたbootstrapで求めています。測った各300件では、W16A16の実機とFP32のCERは近い値でした。表のCERが同じでも、全発話の認識文字列が同じという意味ではありません。

評価の正解文はpyopenjtalk-plusで読みへ変換しています。モデルカードの評価とは正解文の作り方が異なるので、前半の21.03%・25.28%とは直接比較できません。また、ReazonSpeech testは学習データと重なる可能性があるため、ここでは量子化・実機化による相対的な変化を見るために使っています。

速度とメモリ

最終的な1秒処理版での測定値は以下です。

項目 測定値
モデル推論時間(中央値) 100フレームあたり約0.454秒
モデル推論のRTF 約0.45
4秒録音終了から認識処理の完了まで 約0.495秒
待機中の内部RAM空き 約59.8KB
待機中のPSRAM空き 約2.75MB

RTFは音声の長さに対する処理時間の比率で、ここではモデル推論だけを測っています。特徴抽出や画面表示の時間は含みません。

録音後の約0.5秒は、録音中に計算を進めたうえで、最後に残った処理を終えるまでの時間です。コード上の計測は画面描画の直前で終わっているため、表示完了までの時間は含みません。

表に載せたメモリ量は待機中の空き容量です。モデル構築時には内部RAMの空きが一時的に少なくなるため、機能を追加する際は起動中のメモリ使用量も確認が必要です。

精度・速度の測定条件と配布ファイルの詳細は、実機版のREADMEにもまとめています。

まとめと今後の課題

約205万パラメータの日本語音声認識モデルを作り、ReazonSpeech約10,000時間で学習して、M5Stack CoreS3のマイク入力から認識結果の表示まで動かしました。

今回試した8bit量子化では精度が下がったため16bitを採用し、待ち時間を短くするために各層の状態を引き継いで1秒ずつ処理する形にしました。

PCやネットワークなしで、話した日本語をひらがなとして表示するところまではできました。一方、文末が抜けるなどの誤認識は残っています。漢字・句読点への変換、長い音声の連続認識、雑音下での使いやすさも今後の課題です。

CoreS3を持っていれば、配布済みのファイルを書き込んで試せます。まず認識結果だけ見たい場合は、ブラウザデモを使ってください。

参考

モデル・推論コード・実機ファームウェアのソースはApache-2.0で公開しています。書き込み用ファイルに含まれるライブラリの条件は、配布先の第三者ソフトウェアのライセンスを参照してください。

約1000万パラメータの日本語言語モデル JMicro-10M を作って学習させてみた

初めに

今回は、約1000万パラメータの日本語言語モデル JMicro-10M を作って、学習から文章生成まで試してみます。Tokenizerも自前で用意して、事前学習と会話向けの追加学習を行いました。

短い決まった質問には答えられるようになりましたが、質問の仕方を変えると答えが抜けたり、会話中の訂正を反映できなかったりと、まだ使える精度にはなっていません。

リポジトリは以下です

github.com

開発環境

モデルの学習は以下の環境で行いました。

  • Windows上のWSL2 / Ubuntu
  • NVIDIA GeForce RTX 4090
  • Python 3.12.7
  • PyTorch
  • uv

Pythonの環境管理には uv を使っています。Tokenizerは最初に M1 iMac のCPUで学習・検証し、モデル本体は WSL2 + RTX 4090 で学習しました。

モデルとデータ

モデルの構成は以下です。

項目 値
パラメータ数 10,001,152
Transformer層数 13
hidden / FFN 256 / 640
Attention GQA、4 query heads / 2 key-value heads
語彙数 4,096
コンテキスト長 1,024 token

Tokenizerは4,096語彙と8,192語彙の2種類を用意しました。語彙を増やすとモデルのパラメータ数も増えるので、今回は短い学習で比較したあと、4,096語彙の構成で進めています。

SentencePieceのUnigramに byte fallback を組み合わせ、語彙にない文字もバイト単位で扱えるようにしました。改行や特殊文字を保持する処理も入れて、学習と推論で同じラッパーを使っています。

データは FineWeb2 Edu Japanese と RealPersonaChat から準備を始めて、その後、事前学習用の日本語Webテキストを追加しています。会話向けの追加学習では、対話データに加えて、名前や好みなどを覚えて答える自作の教材も試しました。

学習してみる

最初に少数の文書を繰り返し学習させて、その続きを出せるか試しました。チェックポイントの保存と学習の再開も確認してから、本学習を進めています。

Baseモデルは、合計約10B(100億)の入力トークンまで学習しました。

評価用テキストの予測損失を表すBPB(低いほどよい)は、2B時点の0.982882から、10B時点の0.954018まで下がりました。一方、80入力でgreedy生成を試したところ、終了トークンのEOSで止まったものは0件、同じ内容の反復は53件でした。lossは下がっていても、生成するとまだ同じ文を繰り返します。

教材は、名前や好きな花など8組の情報を使い、覚える・訂正する・質問するパターンを変えた64問です。Assistant側の教師トークン約25万で483回更新し、学習に使った64問はすべて正解文を再現できました。

生成結果

以下は同じSFTモデルで生成した結果です。生成条件は BF16 / math backend、greedy、最大32新規トークンにしています。3例とも応答終了を表すEOTで止まりました。

教材にある質問には答えられる

まずは学習に使った質問です。以下の履歴を入力して、続きを生成します。途中の「わかりました。」は、あらかじめ用意した返答です。

User: 自己紹介の情報を覚えてください。名前はミナです。好きな花はすみれです。
Assistant: わかりました。
User: 今の名前と好きな花を短く教えてください。

出力は以下でした。

名前はミナです。好きな花はすみれです。

名前と好きな花の両方が返ってきました。学習に使った質問なので、ここは教材を覚えられたかの確認になります。

質問の形を変えると片方が抜ける

次は同じ名前と花で、伝える順序や質問の仕方を変えたものです。こちらも途中のAssistantの返答は、あらかじめ用意しています。

User: 自己紹介について伝えます。好きな花はすみれです。名前はミナです。
Assistant: はい、伺いました。
User: ノートを閉じました。情報の変更はありません。
Assistant: はい、伺いました。
User: これまでの訂正も踏まえ、好きな花、名前について現在の内容を答えてください。
名前はミナです。

名前は返ってきましたが、好きな花が抜けています。同じ聞き方で値だけを変えた問題では30/32問が正解でしたが、聞き方や配置を変えて二つの情報を答える問題は0/16問でした。

語順や相づちなどをまとめて変えているので、どの変更が原因かまでは分かりませんが、教材と違う聞き方にはまだ弱いです。

会話中の訂正を反映できない

最後は、途中のAssistantの返答もモデルに生成させて会話を続けた結果です。

User: 注文を覚えてください。飲み物は煎茶です。温度は熱めです。
Assistant: 注文は煎茶です。
User: 飲み物だけ訂正します。飲み物は甘酒です。もう一方は変えません。今の飲み物を短く教えてください。
Assistant: 飲み物は煎茶です。
User: 今の飲み物と温度を短く教えてください。
Assistant: 飲み物は煎茶です。温度は熱めです。

飲み物を甘酒に訂正しても、煎茶のままでした。最後は温度も返してくれていますが、飲み物は直っていません。

今回の集計は開発用の固定問題をCodexで採点したものです。モデル名などを隠した評価ではなく、普段の会話での正答率を測ったものでもありません。入力と出力は以下にまとめています。

github.com

まとめ

約1000万パラメータの日本語モデルを作って、Tokenizerの学習から文章生成まで試してみました。

決まった質問には答えられるようになりましたが、聞き方を変えたり、会話中に情報を訂正したりすると崩れてしまいます。今回はまだ普通の会話に使える精度にはなりませんでした。

参考

Baseモデルは以下で公開しています。

huggingface.co

今回の生成結果に使ったSFTモデルはこちらです。

huggingface.co

学習設定や評価の詳細は、リポジトリ内にまとめています。

macOS 26 の新音声認識 API SpeechTranscriber を試す

初めに

macOS 26 / iOS 26 で Speech framework に SpeechAnalyzer と SpeechTranscriber が追加されました。Apple の説明では Notes・ボイスメモ・Journal といった純正アプリが使っているモデルがそのまま開放されたもので、完全オンデバイス・通信量ゼロ・モデルのダウンロード実装も不要です。

developer.apple.com

developer.apple.com

SpeechTranscriber とは

旧 SFSpeechRecognizer 新 SpeechTranscriber
実行場所 端末 or Apple サーバー 完全オンデバイス固定
発話長の上限 実質 1 分程度 なし
音声認識の TCC 権限 必要 不要
結果の型 String AttributedString(信頼度・時間範囲つき)
対応ロケール 63 30(DictationTranscriber は 43)
必要 OS iOS 10 〜 macOS 26 / iOS 26 以降

開発環境

  • macOS 26.2 (25C56)
  • Xcode 26.0.1
  • Swift 6.2 / SDK は MacOSX26.sdk
  • Apple M4 Max (64GB)

動かしてみる

SwiftPM パッケージも Xcode プロジェクトも作らず、単一ファイルの @main を swiftc に直接渡す形で試しました。

xcrun --sdk macosx swiftc -parse-as-library -swift-version 6 transcribe-file.swift -o /tmp/transcribe
/tmp/transcribe path/to/audio.wav ja-JP

-parse-as-library は @main を使うために必須です。あと xcrun --sdk macosx を付けないと、素の swiftc が CommandLineTools 側の SDK を見に行って失敗しました。テスト音声は say -v Kyoko -o out.aiff "テキスト" ですぐ作れます。

中身は SpeechAnalyzer に SpeechTranscriber を挿して音声を流し込むだけです。

guard let locale = await SpeechTranscriber.supportedLocale(
    equivalentTo: Locale(identifier: "ja-JP")) else { return }

let transcriber = SpeechTranscriber(
    locale: locale,
    transcriptionOptions: [],
    reportingOptions: [.volatileResults],
    attributeOptions: [.audioTimeRange, .transcriptionConfidence]
)

// アセットが無ければ取得する。入っていれば 1 秒未満で返る
if let req = try await AssetInventory.assetInstallationRequest(supporting: [transcriber]) {
    try await req.downloadAndInstall()
}
_ = try await AssetInventory.reserve(locale: locale)

let analyzer = SpeechAnalyzer(modules: [transcriber])

// 結果の収集は analyzeSequence より「先に」立てる
let consumer = Task { () -> [String] in
    var finals: [String] = []
    for try await result in transcriber.results where result.isFinal {
        finals.append(String(result.text.characters))
    }
    return finals
}

_ = try await analyzer.analyzeSequence(from: AVAudioFile(forReading: url))
try await analyzer.finalizeAndFinishThroughEndOfInput()
let finals = try await consumer.value

ハマったところ

ハマったこと 対処
結果が空になる transcriber.results は解析中に流れるので、収集タスクは analyzeSequence より先に立てる
最後の結果が出ず、ループも終わらない finalizeAndFinishThroughEndOfInput() を必ず呼ぶ
sending risks data races で落ちる Swift 6 の strict concurrency。Task { () -> T in ... return ... } の戻り値で受ける
アセットが入っているのに .supported が返る AssetInventory.status ではなく、assetInstallationRequest(supporting:) が nil かどうかで見る
結果が String で取れない AttributedString なので String(result.text.characters)。信頼度と時間範囲は run の属性
マイク入力が実行時に SIGTRAP で即死する 下記

マイクだけは少し厄介でした。ファイル入力が動いたので同じノリで書いたら、コンパイルは通るのに再生した瞬間に落ちます。

libdispatch           _dispatch_assert_queue_fail
libswift_Concurrency  _swift_task_checkIsolatedSwift
<自分のバイナリ>       closure #1 in static Main.main()
AVFAudio              AVAudioNodeTap::TapMessage::RealtimeMessenger_Perform()

@main の static func main() は MainActor 隔離されるので、installTap に渡したクロージャに隔離チェックが挿入され、実時間オーディオスレッドから呼ばれた瞬間にアウト、という理屈でした。回避には nonisolated static func main() にする・クロージャを { @Sendable buf, _ in ... } にする・状態を Sendable なクラスに閉じ込める、の 3 つが全部必要です。

参考

API の一次情報は SDK 同梱の .swiftinterface を読むのが早いです。公式 Web ドキュメントは JS レンダリングで取得しづらいことが多いので、こちらを直接見ていました。

/Applications/Xcode.app/Contents/Developer/Platforms/MacOSX.platform/Developer/SDKs/MacOSX.sdk/System/Library/Frameworks/Speech.framework/Versions/A/Modules/Speech.swiftmodule/arm64e-apple-macos.swiftinterface

使ったコーパスは次の 2 つです。音声と参照テキストは再配布条件があるため、この記事には結果の数値と、説明に必要な範囲の引用だけを載せています。

tyc.rei-yumesaki.net

huggingface.co

英語のストリーミング音声認識モデル moonshine-streaming-small を日本語化して kodama-ja-streaming-small を作成する

初めに

日本語のリアルタイム音声認識を自分のアプリに載せようとすると、毎回同じところで詰まります。 CPU でオフラインに動く・確定までの遅延が短い・商用利用できる、この3つが同時に揃った選択肢が薄いのです。

モデル サイズ ストリーミング ライセンス
openai/whisper-large-v3 1.54B params ✕ Apache-2.0
reazon-research/reazonspeech-nemo-v2 — RNN-T・未検証 Apache-2.0
moonshine-base-ja(公式日本語) 61.5M params ✕ Moonshine Community License(非商用・撤回可能)
vosk-model-ja-0.22 1GB ○ Apache-2.0
vosk-model-small-ja-0.22 48MB ○ Apache-2.0
moonshine-streaming-small(英語) 140.1M params ○ MIT

Whisper 系は精度も汎用性も強いのですが、大きいうえにそもそもネイティブなストリーミング ASR ではありません。 音声インターフェースのループに入れるには重すぎます。

Moonshine は逆側に振った設計で、Encoder の受容野が有界なので確定遅延を詰められます。 表の最終行がそれで、3つの条件をすべて満たしています。ただし英語専用です。

公式には日本語版(moonshine-base-ja / moonshine-tiny-ja)も出ていますが、こちらは Moonshine Community License(非商用・撤回可能)扱いになります。同じ土俵に立てるオープンな選択肢は 実質 Vosk だけ、という状態でした。

なお reazonspeech-nemo-v2 の遅延はこちらでは測っていません。CER は測りましたが、 ストリーミング動作と確定遅延は未検証なので「○」とは書けませんでした。

そこで、MIT で公開されている英語版 moonshine-streaming-small を日本語で追加学習し、 Apache-2.0 で公開することにしました。

作ったもの

huggingface.co

項目 値
パラメータ数 140,135,225(実測。ベースのモデルカード表記は 123M)
ベースモデル moonshine-ai/moonshine-streaming-small(MIT・英語)
学習データ ReazonSpeech v2 全量 35,000 時間 × 2 epoch(CDLA-Sharing-1.0)
配布形式 safetensors + ONNX / ORT deploy 資産
ONNX deploy サイズ 324MB(.ort は 319.6MB)
offline RTF 0.19(CPU)
ライセンス Apache-2.0

総合力では公式日本語 Moonshine base に届いていません。勝っているのは 感情表現・キャラクター音声・対話であって、汎用(FLEURS)・短発話・固有名詞・雑音では負けています。 特に雑音が最大の弱点で、SNR 10dB の条件では CER が +0.1033 も悪いです。

一方、同じ土俵(CPU オフライン・ストリーミング・パーミッシブライセンス)にいる Vosk に対しては、 48MB 版に測定 6 セット全勝、1GB 版にも 6 セット中 5 セットで優位に立てました。

向いている用途

  • キャラクターボイス・感情表現のある音声の書き起こし
  • 音声対話アプリのリアルタイム入力(CPU のみ・クラウド送信なし)
  • 商用プロダクトへの組み込み(Apache-2.0)
  • 学習データの由来を説明する必要がある案件(ReazonSpeech v2 単独で、素性が開示できます)

向いていない用途

  • 雑音のある環境(最大の弱点です。SNR 10dB で CER 0.2363)
  • ニュース読み上げのような汎用・高精度用途(FLEURS では公式日本語 Moonshine に負けます)
  • 固有名詞や短い発話が多い用途
  • 確定までの遅延がシビアな用途(Vosk big のほうが速いです。遅延の節を参照してください)
  • 無音区間で何も出力してほしくない用途。hallucination_rate が 0.10〜0.12 あり、 学習データを 35倍にしても値が変わらなかったので、VAD と組み合わせる前提で使ってください。

使い方

配布しているのは ONNX / ORT の deploy 資産です。3グラフで1セット・1モデルになっています。

  • onnx/encoder.onnx + .onnx.data(207.9MB・float)— 音響エンコーダ
  • onnx/cross_kv_prefill.onnx + .onnx.data(32.5MB・float)— cross-attention KV の前計算
  • onnx/decoder_step_crosskv.int8a.onnx(83.1MB・int8)— 1ステップ decode

呼び出しは encoder → cross_kv_prefill → decoder_step の順で、最後の decoder_step を トークンごとに繰り返します。ストリーミングで使う場合は、encoder に有界文脈窓 (左 160 フレーム・右 16 フレーム)を与えて block ごとに回し、確定した分だけを凍結していきます。

.ort 版(ort/・計 319.6MB)はモバイル/組込み向けの事前最適化形式です。

⚠️ 同梱の .ort は公式 moonshine-voice の6グラフ束とは非互換です(3グラフ分割で I/O 名と cache レイアウトが異なります)。公式ランタイムにそのまま差し込むことはできません。

⚠️ 遅延や RTF は必ず ONNX Runtime 経路で測ってください。PyTorch / Transformers からも (MoonshineStreamingForConditionalGeneration で)読み込めますが、Transformers 実装は 効率的なストリーミング経路が未完成だとベースモデル側が明記しています。この記事の遅延値は すべて ONNX Runtime 経路の実測です。オフライン推論のコード例はモデルカードに載せています。

なぜ Moonshine Streaming Small を土台にしたのか

アーキテクチャ側の理由

Moonshine Streaming の Encoder は受容野が有界で、あるフレームの出力は 左 160 フレーム・右 16 フレームの範囲にしか依存しません。右 16 フレームが先読みにあたります。

この性質のおかげで、有界な文脈窓を切って逐次 encode しても full-utterance の結果と一致します。 実際に検証したところ、両者の差は max|Δ| で 4.8e-5 でした。streaming 化のために再 export が要らない という、実装上かなり効く特性です。

先読み量については注意が要ります。公式モデルカードは「約 80ms」と書いていますが、 自分の ONNX 実装で測ると右文脈 16 フレーム= 320ms でした。この記事の数値は後者です。

パラメータ数も同様で、モデルカードの 123M に対し、safetensors のヘッダから数えた実測は 140,135,225(262 テンソル・全 F32・560,571,228 bytes)でした。アーキテクチャも語彙も変えていないので、 日本語化後もこの数字は変わりません。

ライセンス側の理由

Moonshine の LICENSE は 1ファイルに2つのライセンスが同居しています。

The code in this repo ... is licensed under the MIT License. The English-language models are also released under the MIT License. See SECTION 1 for terms.

Models for other languages are released under the Moonshine Community License, which is a non-commercial license. See SECTION 2 for terms.

Community License は非商用・撤回可能で、Derivative Work の定義に fine-tune / LoRA / 量子化を 明示的に含みます。すると当然こういう論点が立ちます。

MIT の英語モデルを日本語で追加学習した派生物は、「他言語モデル」として Community License に落ちるのか?

落ちるなら、このプロジェクトは成立しません。結論としては落ちないと判断しました。根拠は3つあります。

  1. 文言の主語です。"Models for other languages are released under..." は、Moonshine AI が 自ら公開するモデルの分類を述べた文であって、第三者が MIT 許諾済みの重みから作った派生物に 後から条件を追加する文言ではありません。
  2. Community License 自身の適用範囲です。第V条の定義が "Moonshine AI Materials" ... made available under this Agreement と限定しています。 moonshine-streaming-small は MIT のもとで提供されていて、この Agreement のもとでは提供されていません。
  3. Moonshine AI 自身による明示的な除外です。Acceptable Use Policy にこう書いてあります。

    These restrictions do not apply to models that have been explicitly released by Moonshine AI under a different license, such as the MIT license.

    AUP は Community License 第 IV(b) 条から参照により本文へ組み込まれています。その AUP が MIT 公開モデルを適用対象外と明言している以上、権利者自身が「MIT で出したものは Community License 系の規律の外にある」と述べていると読めます。

学習データ側も確認しました。ReazonSpeech v2 は CDLA-Sharing-1.0 ですが、§3.5 が This Agreement imposes no obligations or restrictions on Your Use or Publication of Results と定めており、学習済み重み(Results)に義務は及びません。帰属表示は良い作法として NOTICE に書きましたが、 これは利用者に CDLA の条件を課すものではありません。

なお公式日本語 Moonshine は、初期重み・tokenizer・decoder のいずれにも一切使っていません。 ベンチマーク比較のためだけに動かしています。

監査中に、license: mit と宣言しながら実体は公式日本語モデル (Community License 系譜)の量子化物、というモデルが 4件見つかりました。Community License 第V条は Derivative Work に量子化を含むので、この表記は成立しません。HF の license タグは信用せず、 base_model を辿って根元の一次ライセンスまで遡る必要があります。

方法

1. 学習より先に評価を作った

最初に手を付けたのは学習ではなく評価ハーネスです。

  • 主指標は CER です(日本語なので WER で最適化しません)。正規化は学習側と評価側で単一実装を共有します。
  • CER だけでは気付けない失敗があるので、hallucination_rate(無音区間に何か出力する率)と 診断セット short / noise / propn(短発話・SNR 10dB 雑音・固有名詞)を足しました。
  • per-utterance のダンプを必ず取り、比較は paired bootstrap CI で判定します(n_boot=1000・seed=0)。 端点だけを見て「改善した」と書かない、というルールを自分に課しました。
  • 評価は原則1プロセスずつ。2プロセス並列で回すと CUDA error: unspecified launch failure で発話が落ち、 その分をモデルの性能として読みかけたことがあります。推論エラー件数を結果に残し、採用前に必ず見ています。

対象ドメインの評価セット(キャラクター音声・感情音声、以下 dom_g)も自前で組みました。 n=629・61.1 分・6話者を manifest hash で凍結してあります。音声は再配布できないので、 公開したのは集計値と hash だけです。

2. レシピは組み合わせたときだけ効いた

warmup の追加と cosine スケジューラへの変更を、単体と組み合わせで試しました。 単体ではどちらも無効で、両方入れたときだけ CER が 0.4131 → 0.4050 に動きます。効果は小さく、 この時点では「レシピはもう伸びしろがない」と判断していました。

3. ピーク LR が低すぎた

Phase 3 以降ずっと lr 2e-5 で固定していて、その値を一度も振っていませんでした。 検証していたのはスケジュールの形だけです。

medium(1,000時間)×3epoch・レシピ固定・batch 128 で、LR だけを振りました。

LR 1e-5 2e-5(従来) 4e-5 8e-5 1.6e-4 3.2e-4
FLEURS 0.4733 0.4050 0.3535 0.3109 0.2791 0.2710
dom_g 0.4330 0.3674 0.3246 0.3040 0.2671 0.2578

従来値の 8倍まで一貫して改善します。medium 1,000時間 × 高 LR は、データ量が 1/5 でありながら large 5,000時間 × lr 2e-5 を両セットで有意に上回りました (FLEURS Δ-0.0375 CI=[-0.0496, -0.0256]/dom_g Δ-0.0475 CI=[-0.0640, -0.0321])。

それまで「medium の頭打ちはデータ不足」と判断して large に進んでいましたが、これは誤診でした。 データ不足と LR 不足は同じ形の頭打ちを示すため、LR を振らない限り切り分けられません。

採用値は 1.6e-4 です。3.2e-4 とは両セットで有意差がなくプラトーに入るため、低いほうを採りました。 LR 修正後にデータを増やしても効果は残っており(5,000時間で FLEURS 0.2186)、 LR とデータは独立に効きます。

4. 35,000 時間まで伸ばした

最終的に ReazonSpeech v2 の全量 35,000 時間 × 2epoch まで回しました。公式日本語 Moonshine base との dom_g の差(正なら負けている)はこう動いています。

世代 dom_g の差 判定
large 5,000h × lr 2e-5(LR 修正前) +0.1582 有意に劣位
medium 1,000h × 高 LR +0.1106 有意に劣位
large 5,000h × lr 1.6e-4 +0.0684 有意に劣位
all 35,000h(最終) +0.0095 有意差なし

データ ×7 でも両セットで有意に改善しており(FLEURS Δ-0.0706/dom_g Δ-0.0588)、まだ飽和していません。

実行環境は vast.ai の RTX 5090 ×4 の DDP です。batch は 128 が最適で、192 は VRAM を 19→26GB 使うのに 6% 遅く、256 は OOM でした。VRAM が余っている=性能が余っている、ではないということです。 2.3TB の tar 前ロードは hf_cdn から並列 16 で引くと 580MB/s 出て、20 時間が 1.2 時間で済みました。

所要時間は事前見積 23.1 時間に対し、実測 86.75 時間でした。根拠にした「4GPU の並列効率 90%」は 80 step のスループット測定の値で、長時間ランでは再現しません(実効 847 audio-h/h = ほぼ単 GPU 相当)。 原因は特定できていません。短時間のベンチは長時間ランの前提には使えません。

ちなみに tokenizer はベースの英語版のままです(語彙 32,768)。日本語 tokenizer への差し替えも 試しましたが、次の節のとおり回収できませんでした。

効かなかった介入

介入 結果
音声データ拡張(SpecAugment 風+速度摂動) 有意差なし(FLEURS Δ+0.0033・dom_g Δ+0.0094、いずれも CI が 0 を跨ぐ)
label_smoothing 実用不可。全 logits を Python 側へ materialize する必要があり約14倍遅いため打ち切り
LM rescoring 前提が成立しない。カタカナ集中度がベースラインと CI 重複= gap は正書法由来ではなかった
日本語 tokenizer への差し替え 1,000時間では head 再初期化のコストを回収できず(維持 0.4194 < 差し替え 0.4639)
多様性データの混合(+Common Voice / +moe-speech) 汎用・対話がむしろ悪化(FLEURS 0.409→0.457・SpeechBSD 0.279→0.355)。in-domain だけ改善(JVNV 0.292→0.227)。⚠️ lr 2e-5 固定下の比較なので、正しい LR では未検証

音声データ拡張の「無効」判定には留保があります。これはクリーン音声での評価であって、 雑音が最大の弱点だと分かった今、雑音耐性の観点では再検証の余地があります。

評価

評価セットと測り方

8セット(fleurs / dom_g / propn / short / noise / speechbsd / jvnv_regular / jvnv_free)を、 同一ハーネス・同一正規化・貪欲デコードで測っています。すべて逐次実行で、n_errors=0 を確認済みです。 比較は paired bootstrap CI(n_boot=1000・seed=0)で判定しています。

なお dom_g と jvnv は独立ではない(dom_g の 227 発話が JVNV 由来)ので、並べるときは 内訳を併記しています。

公式日本語 Moonshine base との比較

比較相手は moonshine-base-ja(61.5M・非ストリーミング・こちらの 44% のサイズ)です。 Δ は ours − baseline なので、負ならこちらが良いことになります。

評価セット n moonshine-base-ja ours Δ 95%CI 判定
jvnv_free 240 0.1121 0.0638 -0.0483 [-0.0698, -0.0271] ours が有意に優位(-43%)
jvnv_regular 800 0.1415 0.0968 -0.0447 [-0.0578, -0.0319] ours が有意に優位(-32%)
speechbsd 800 0.1320 0.1108 -0.0213 [-0.0363, -0.0069] ours が有意に優位(-16%)
dom_g 629 0.1472 0.1567 +0.0095 [-0.0063, +0.0245] 有意差なし
short 130 0.1168 0.1448 +0.0281 [+0.0046, +0.0517] ours が劣位
propn 248 0.1354 0.1695 +0.0341 [+0.0134, +0.0534] ours が劣位
fleurs 650 0.1091 0.1480 +0.0390 [+0.0286, +0.0515] ours が劣位
noise(SNR10dB) 400 0.1330 0.2363 +0.1033 [+0.0855, +0.1239] 最大の弱点

「公式日本語 Moonshine を超えた」とは言えません。唯一 dom_g が有意差なしまで来ましたが、 点推定では依然ベースラインが上(0.1472 対 0.1567)ですし、「有意差なし」は同等と区別できないという 意味であって優位ではありません。総合力ではまだ負けています。

雑音の弱さは構造的なものです。clean からの劣化率は ours が +60%、ベースラインが +22% で、 学習データ(ReazonSpeech)が比較的クリーンなことが効いていると考えられます。

「有意差なし」は話者間の相殺だった

dom_g の合計値だけを見ていると一様に同等に見えますが、話者ごとに分解すると打ち消し合っていました。

話者 n moonshine-base-ja ours Δ 95%CI 判定
あみたろ 302 0.1120 0.1908 +0.0788 [+0.0596, +0.0981] 有意に劣位
つくよみちゃん 100 0.2532 0.2879 +0.0347 [+0.0030, +0.0661] 有意に劣位
JVNV 227 0.1281 0.0644 -0.0637 [-0.0868, -0.0432] 有意に優位
合計 629 0.1472 0.1567 +0.0095 [-0.0063, +0.0245] 有意差なし

キャラクター音声の2話者では負けています。35,000 時間でも埋まりませんでした。合計値だけを出すと 実態より良く見えるので、モデルカードにもこの内訳を併記してあります。

もうひとつ留保があります。dom_g の素材は ITA / JVS の公開台本の読み上げで、比較相手は学習データを 開示していません。したがって汚染の可能性は排除できず、判定は fail-closed で UNKNOWN のままです。 差が縮んだ今、この留保の重要度はむしろ上がっています。JVNV だけ突出して良いのも、 汚染の疑いを強める方向の所見ではあります(どちらが汚染されているかは判定できません)。

Vosk との比較

同じ土俵(CPU オフライン・ストリーミング・パーミッシブライセンス・Apache 2.0)にいる直接競合が Vosk(Alpha Cephei・Kaldi hybrid)です。n を揃えて測りました。

モデル サイズ fleurs dom_g propn speechbsd jvnv_regular jvnv_free
ours 324MB 0.1480 0.1567 0.1695 0.1108 0.0968 0.0638
vosk-model-ja-0.22 1GB 0.1703 0.1776 0.2012 0.1303 0.1459 0.0747
vosk-model-small-ja-0.22 48MB 0.2248 0.2478 0.2625 0.1712 0.1551 0.1000
  • 48MB 版には 6 セット全勝で、相対 34〜38% の改善です。すべて CI が 0 を跨ぎません。
  • 1GB 版には 6 セット中 5 セットで有意に優位です。サイズは 1/3 になります。 ⚠️ ただし jvnv_free だけは有意差なし(Δ-0.0109 CI=[-0.0257, +0.0040])なので、 「1GB に全セット勝った」とは書けません。

雑音条件では Vosk と比較していません。Kaldi hybrid は雑音に強い可能性がありますし、 こちらは雑音が最大の弱点なので、上の「全セット優位」を雑音環境に一般化してはいけません。

推論性能

精度とは測定条件が違うので、表は分けています。

ONNX 化 — 3グラフに分けて decoder だけ int8

最終的な deploy 構成は float encoder + float cross_kv prefill + int8a decode step の3グラフです。 565MB → 324MB(.ort で 319.6MB)に落ちました。

  • PyTorch 経路との一致は、float 経路で token-id 24/24 が bit-exact でした。
  • decoder の int8 化は offline CER が無劣化です(float 0.1058 = int8a 0.1058)。
  • encoder の int8 化は不可でした。careful な static QDQ でもゲートを通らず、 float 維持の 208MB が下限になります。ここが「もっと小さくできないか」に対する構造的な答えです。

ストリーミングは精度と確定遅延のトレードオフ

逐次デコードをそのままやると AED では出力が壊れる(CER 0.78)ので、 bounded-tail revision(local-agreement)で「後から書き換わらないと確信できた分だけ凍結する」方式にしました。 どこまで待って凍結するかが margin で、これを振ると CER と Finalization が逆方向に動きます。

実効 margin CER offline との差 Finalization
12 0.2159 +0.1101 608ms
24(採用) 0.1596 +0.0538 883〜957ms
凍結なし 0.1288 +0.0230 2227ms

ここで前提をひとつ撤回しています。以前は「streaming でも CER 無劣化」と結論していましたが、 それは古い重みに限った所見でした。当時は offline 自体が 0.369 と悪く、streaming の劣化が埋もれていたのです。 offline が 0.106 まで改善したことで失うものが増え、同じ margin 12 のまま測ると +0.1101 も劣化します。

採用値を margin 24 に変えて劣化を半分に抑え、Finalization を 1 秒以内に収めました。それでも CER は +0.0538 劣化します。offline の精度をそのまま streaming の性能として出してはいけない、 というのがこの節の結論です。

遅延の実測

block 500ms・同一マシン・CPU で測っています。n は行ごとに異なります(ours は 24、Vosk は 8)。

モデル サイズ TTFP(初回部分結果) Finalization(確定まで) offline RTF
ours(margin 24) 324MB 1091〜1138ms 883〜957ms 0.19
vosk-model-small-ja-0.22 48MB 5997ms 29ms 0.62
vosk-model-ja-0.22 1GB 1082ms 133ms 0.21
  • 48MB の Vosk は「小さいが低遅延ではない」という結果でした。TTFP で約 5.3倍、RTF で 3.3倍こちらが速いです。 サイズが小さいことは低遅延を意味しません。
  • 1GB の Vosk とは TTFP・RTF は同等ですが、Finalization で 6.6〜7.2倍負けています。 AED は全 encoder フレームに cross-attend するので、Kaldi の増分デコードには構造的に及びません。 パラメータ調整では埋まらない差です。対話 UI の体感を最も左右する指標なので、 そこが重要な用途では Vosk big のほうが適しています。
  • Vosk 側の endpointing は無効のまま測っています(有効なら Vosk の Finalization はさらに前倒しになります)。

参考

公開したモデル

huggingface.co

土台にした実装

使ったデータ

  • 学習: ReazonSpeech v2(CDLA-Sharing-1.0)
  • 評価: FLEURS / SpeechBSD / JVNV / ITA・JVS コーパス

比較対象

  • moonshine-base-ja(Moonshine Community License・ベンチマーク比較にのみ使用)
  • vosk-model-small-ja-0.22 / vosk-model-ja-0.22(Apache 2.0)

ストリーミング音声変換モデル MeanVC2 を Windows + uv で動かしてみる

初めに

今回は、低遅延ストリーミングのゼロショット音声変換モデル MeanVC2 を、Windows ネイティブ環境 + uv で動かして、マイク入力のリアルタイム変換まで試してみます。

公式リポジトリは conda + pip 前提の手順になっているので、そこを uv に置き換えつつ、実際に詰まったところも合わせて書いていきます。

MeanVC2 とは

MeanVC2 は、西北工業大学の ASLP@NPU が公開しているストリーミング向けのゼロショット音声変換モデルです。前作 MeanVC の課題(学習効率・小チャンク時の品質劣化・低品質な参照音声への弱さ)を改善したもの、という位置づけになっています。

特徴としてはこのあたりです。

  • エンドツーエンドで 110ms の遅延(40ms チャンク時)。前作 MeanVC(160ms) の 211ms からほぼ半減
  • Future-Receptive Chunking (FRC): DiT の層ごとに過去/未来の受容野を明示的に配分することで、短いチャンクでも安定して変換できる。GPU のピークメモリも約 60% 削減
  • Universal Timbre Token Encoder (UTTE): 話者埋め込みを K 個の key-value ペアに変換し、BNF を query とした cross-attention で音色を引いてくる。参照音声の品質が低くても崩れにくい
  • Mean Flows + 1-NFE 推論: ODE を 1 ステップで解く
  • 18M パラメータと軽量

構成は認識-合成(recognition-synthesis)パラダイムで、ストリーミング ASR(Fast-U2++)が内容表現(BNF)を抽出し、DiT ベースの CFM デコーダがターゲットのメルスペクトログラムを生成、最後に Vocos ボコーダで 16kHz の波形にする、という流れです。

開発環境

  • Windows 11
  • uv 0.11.8
  • Python 3.11.10
  • NVIDIA GeForce RTX 4070 Ti SUPER (16GB)
  • torch==2.5.1+cu121

環境構築

uv で環境を作る

公式 README は conda で環境を作って pip で入れる手順ですが、uv に置き換えます。PyTorch だけ CUDA 12.1 の公式 wheel index から取ってくる必要があるので、pyproject.toml でインデックスを明示的に分けます。

[project]
requires-python = ">=3.11,<3.12"
dependencies = [
    "torch==2.5.1",
    "torchaudio==2.5.1",
    # ... 以下略
]

[tool.uv]
package = false

[[tool.uv.index]]
name = "pytorch-cu121"
url = "https://download.pytorch.org/whl/cu121"
explicit = true

[tool.uv.sources]
torch = { index = "pytorch-cu121" }
torchaudio = { index = "pytorch-cu121" }

explicit = true にしておくと、[tool.uv.sources] で明示したパッケージだけがこのインデックスを見に行きます。これを付けないと他のパッケージまで PyTorch のインデックスを探しに行って遅くなります。

あとは同期するだけです。

git clone https://github.com/ASLP-lab/MeanVC2.git
cd MeanVC2
uv sync --locked

requirements.txt の依存関係でハマった点

そのままだと依存解決が通らなかったので、requirements.txt を何点か直しています。

1. fairseq が omegaconf と衝突する

requirements.txt には fairseq>=0.12 と omegaconf>=2.3 の両方が入っていますが、fairseq 0.12 は omegaconf<2.1 を要求するので解決できません。コードを追った限り fairseq を直接 import している箇所は無かったので、外しました。

2. jiwer のバージョン上限

同じく解決を通すため jiwer>=3.0,<4.0 に制限しました。

3. 実際に import されているのに書かれていないパッケージがある

safetensors と sounddevice が requirements.txt に無いのに実行時に import されます。リアルタイムモードは sounddevice が無いと動かないので、両方追加しました。

-fairseq>=0.12
-jiwer>=3.0
+jiwer>=3.0,<4.0
+safetensors>=0.5
+sounddevice>=0.5

モデルのダウンロード

前処理用・VC 本体・ボコーダのチェックポイントを一括で落とします。

uv run python initialization.py --task all

実行

ファイル変換

ソース音声とターゲット話者の音声を渡すだけで変換できます。事前の特徴量抽出は不要です。

uv run python src/infer/infer_e2e.py --model 120ms `
    --source-wav source.wav `
    --target-wav target.wav `
    --output-wav output.wav --steps 3

モデルは 120ms(品質重視)と 40ms(低遅延)の 2 種類が選べます。

リアルタイム変換(マイク入力)

runtime/run_rt.py を使うとマイク入力をそのまま変換できます。

uv run python runtime/run_rt.py --mode realtime --model 120ms `
    --device cuda --target-spk target.wav

--device のデフォルトが cpu になっているので、GPU で回したい場合は明示的に --device cuda を渡す必要があります。ここは最初素で実行して「やたら遅いな」と気づきました。

参照話者にはつくよみちゃんコーパスの音声を 1 ファイル指定しています。

起動するとこんなログが出ます。

==================================================
MeanVC Real-Time Streaming Voice Conversion
==================================================
  Device:     cuda
  Model:      120ms (src/config/config_120ms_40ms.json)
  Mode:       realtime
==================================================
[Init] Loading ASR encoder (JIT)...
[Init] Loading VC model...
[VC] Total parameters: 17,748,688
[Init] Loading vocoder...
[Init] Loading speaker model...
[Init] Speaker embedding shape: torch.Size([1, 256])

[Stream] Using sounddevice for real-time I/O
[Stream] Warming up...
[Stream] Running. Press Ctrl+C to stop.

パラメータ数は 17,748,688 で、README にある約 18M と一致しています。話者埋め込みは 256 次元です。

実行結果

リアルタイム処理のレイテンシ

実行中は 1 チャンクごとの処理時間がログに出ます。120ms モデルのランタイムでは 1 チャンク = 160ms なので、処理時間がこれを超えると音が途切れます(WARN OVERRUN)。

[1055] 83.2ms / 160ms OK  buf=40ms
[1065] 76.9ms / 160ms OK  buf=0ms
[1075] 94.5ms / 160ms OK  buf=80ms
[1126] 169.8ms / 160ms WARN OVERRUN  buf=80ms
[1136] 77.9ms / 160ms OK  buf=40ms

約 5 分間(1600 チャンク以上)連続で回したときの結果がこちらです。

項目 1 回目 2 回目
処理チャンク数 1796 (約 287 秒) 1618 (約 259 秒)
処理時間 中央値 71.7ms 75.7ms
処理時間 最小 55.0ms 55.3ms
オーバーラン発生率 0.39% 1.17%
オーバーラン時の最大値 217.0ms 207.7ms

160ms のチャンクに対して中央値 70〜80ms 程度なので、RTX 4070 Ti SUPER なら余裕を持って間に合っています。オーバーランも 1% 前後で、体感でも途切れはほとんど気になりませんでした。

なお、たまに 160ms を超えるのは他プロセスの GPU 使用と重なったタイミングのようでした。バッファ(buf=)が 0〜80ms の範囲で振動しているので、そこで吸収できている状態です。

cp932 で落ちる問題

Windows で標準出力をファイルにリダイレクトすると、リアルタイムモードが途中で落ちます。

UnicodeEncodeError: 'cp932' codec can't encode character '⚠' in position 21: illegal multibyte sequence

オーバーラン時のログに ⚠ (U+26A0) が使われているためです。コンソールに直接出している間は問題ないのですが、リダイレクトすると出力先のエンコーディングが cp932 になって落ちます。しかもこれが sounddevice のコールバック内で起きるので、原因が分かりにくいです。

ここは ASCII に置き換えて回避しました。

-            flag = "⚠ OVERRUN" if proc_ms > chunk_ms else "OK"
+            flag = "WARN OVERRUN" if proc_ms > chunk_ms else "OK"

環境変数 PYTHONUTF8=1 を立てるか、PYTHONIOENCODING=utf-8 でも回避できるはずです。

まとめ

MeanVC2 を Windows ネイティブ + uv で動かして、マイク入力のリアルタイム変換まで確認できました。

  • requirements.txt の fairseq を外し、safetensors と sounddevice を足せば uv で環境が作れる
  • --device cuda の指定を忘れない
  • RTX 4070 Ti SUPER で 160ms チャンクに対して処理時間の中央値は 70〜80ms 程度、オーバーラン率は 1% 前後
  • Windows でログをリダイレクトすると cp932 で落ちるので、ASCII 化するか PYTHONUTF8=1 が必要

zero shotのリファレンスなので、音声の類似度はそこまで高くないです

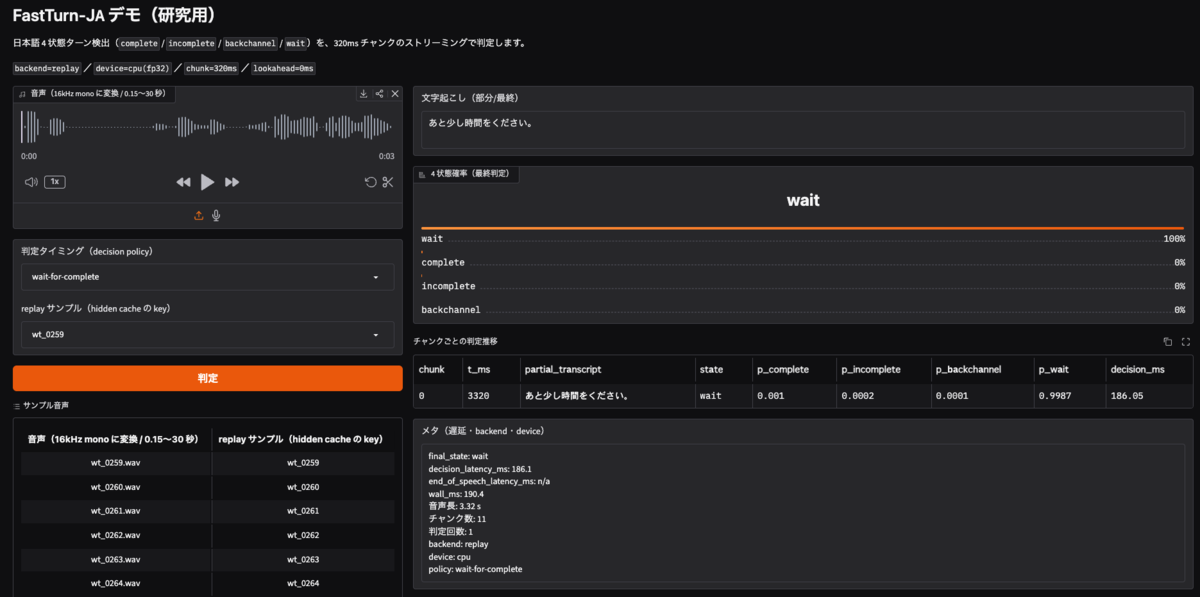
音声を聞きながら 4 状態のターン検出をする「FastTurn」の日本語モデルを作る

初めに

音声対話システムで地味に難しいのが、相手が話し終わったかどうかの判定です。VAD は音が止まったことしか教えてくれないので、無音の閾値を短くすると言い淀んだだけで割り込み、長くすると応答が遅くなります。

前回、これを4状態で判定する Easy Turn の日本語対応モデルを作りました。

ayousanz.hatenadiary.jp

モデルは以下で公開をしています

huggingface.co

状態 意味 システムの取るべき動作
Complete 話し終わった 応答を開始する
Incomplete まだ続く 黙って聞き続ける
Backchannel 相槌(「うん」「へー」) 自分の発話を止めない
Wait 「ちょっと待ってください」 長めに待つ

ただし Easy Turn は VAD の後段に置く再判定器で、判定の前に ASR の転写を出し切る必要があります。実測で P95 291ms かかっていました。

FastTurn は、同じ4状態を VAD 非依存のストリーミングで判定する論文です(arXiv:2604.01897、Easy Turn と同じ ASLP-lab / Lei Xie グループ)。全文の転写を待たず、ストリーミング CTC が吐く途中の文字列とエンコーダの中間表現の両方を使います。論文の報告値は Accuracy 79.62% / 平均遅延 120.1ms で、同じ表の Easy Turn が 78.05% / 297.1ms です。精度は同等で遅延が 2.5 分の1、という位置づけになります。

前回作ったものとの違いを並べると、こうなります。

観点 Easy Turn 日本語版(exp11a) FastTurn 日本語版(今回)
音声エンコーダ Whisper-Medium(オフライン) Nemotron FastConformer(ストリーミング)
意味の取り出し方 全文を転写してから判定する CTC の途中の文字列を逐次受け取る
LLM Qwen2.5-0.5B-Instruct Qwen3-0.6B
判定の出し方 LLM が状態トークンを生成する 3層 MLP(Unified の場合)
音響情報 暗黙(Whisper の特徴のみ) 明示的に融合する(Acoustic Adapter)
動作 VAD の後段に置く再判定器 VAD 非依存のストリーミング
判定する状態 4状態 同じ4状態

違いの本質は3つです。

  • エンコーダ: オフライン → ストリーミング(遅延と VAD 非依存性の根拠)
  • 意味の取り出し: 全文の転写 → 途中の文字列(同上)
  • 音響情報: 暗黙 → 明示的な融合(論文の新規性)

これを日本語で作りました。ただし FastTurn は公式の checkpoint も推論コードも公開されていないので、論文から組み直しています。

作ったもの

5つの系統を実装して、同じ評価セット(実会話150件+合成 wait 50件)で並べました。

系統 構成 Macro-F1 C/I Youden J 相槌 F1
VAD-only(τ=550ms) 無音の長さのみ 0.150 0.10 0.000
Cascaded ASR の文字列を LLM へ 0.538 0.02 0.600
Semantic 音声表現を LLM の入力に足す 0.639 0.36 0.521
Unified 音響情報を出力側でも融合 0.718 0.44 0.727
exp11a(前回の Easy Turn 日本語版) Whisper と Qwen2.5、VAD の後段 0.810 0.46 0.898

結果は3点です。

  • 再現できた — 論文が示す積み上がり方(VAD-only < Cascaded < Semantic < Unified)
  • 勝った — 遅延。エンコーダ込みで P95 110.2ms(エンコーダ 59.6 + 判定器 50.6)。前回の 291ms の約 2.6 分の1
  • 届かなかった — 精度。前回のモデルに 0.718 対 0.810

狙いは「精度は同等、勝つのは遅延」だったので、半分の達成です。論文の中心にある「音響融合で最良になる」も検証できていません。当初は Unified が Semantic を 0.079 上回ったのですが、学習の乱数を変えて12回ずつ測ると +0.019(z=+1.25)まで縮みました(後半に書きます)。

数値の比較範囲について2点あります。論文の報告値(中国語と英語で 22,432件)とこの表(日本語で 200件)は、別のデータセットなので比較していません。前回の記事も 824件の別セットで測っていて、同じ exp11a が 0.649 と出ています。比較が成立するのは、5系統を同じ 200件で測ったこの表の中だけです。

論文が規定していること、していないこと

公式リポジトリにあるのは README と構成図、それにテストセットだけです。Easy Turn のときは checkpoint.pt が 3.45GB で降ってきたので動かして確かめられましたが、今回はできません。

論文を読んで、構造について明確に規定されているのは5点でした。Conformer の中間 hidden を使うこと、Acoustic Adapter は4層 Transformer であること、それを LLM の hidden と融合すること、3層 MLP の Turn Detector を置くこと、Fusion 段で Adapter と Detector を学習すること。

逆に、音響の系列をどう固定長にするのか、融合をどの演算でやるのかは書かれていません。ここは自分で決めました。

組み上がった全体像です。

音声 (16kHz)
  → Nemotron-3.5-asr-streaming-0.6b (24層 FastConformer, 320ms chunk)
     ├─ CTC の途中の文字列 → Qwen3-0.6B ────────────→ Cascaded
     └─ 中間 hidden (T, 1024)
          ├─ LLM Adapter (4層 Transformer, 34M) → Qwen3-0.6B → Semantic
          └─ Acoustic Adapter (4層 Transformer)
                    └→ LLM hidden と融合 → 3層 MLP Turn Detector → Unified

エンコーダは中間表現を取り出せるかで選ぶ

エンコーダに求められる条件は構成から決まります。CTC の途中の文字列と、Acoustic Adapter に渡す中間 hidden の両方を、ストリーミングで出せることです。

日本語で使える候補として ReazonSpeech の2種類を実機で比べました。

k2 Zipformer NeMo (nemo-v2)
途中の文字列 出る 出る
中間 hidden 取得不可 [1, 1024, 112] float32
最終転写 完全一致(CER 0.0) 前半が脱落

転写がいちばん正確だった k2 Zipformer が、この時点で失格しました。ONNX 配布で torch のエンコーダが存在せず、中間層の出力を取り出す先がありません。推論はできても Acoustic Adapter が作れません。論文どおりのアーキテクチャを組むなら、ASR の精度だけで選ぶと、あとから作れないものが出てきます。

採用したのは nvidia/nemotron-3.5-asr-streaming-0.6b(24層 FastConformer、OpenMDW-1.1)です。論文は 12層の Conformer を中英3万時間超で事前学習していますが、そこは学習済みの多言語ストリーミングモデルで置き換えました。

中間 hidden の取り出しは、公式スクリプトを書き換えず、モデルをロードした直後に hook を差し込む形にしました。

def _ft_hook(_m, _i, o):
    t = o[0] if isinstance(o, (list, tuple)) else o
    if hasattr(t, "shape"):
        _FT["hidden"].update(captured=True, shape=list(t.shape), dtype=str(t.dtype))
asr_model.encoder.register_forward_hook(_ft_hook)

asr_model.encoder に1つ仕掛けるだけで取れます。取れた形は [1, 1024, N] で、N はチャンク内のフレーム数です。次元が 1024 と分かったので、Adapter の入力側はここで決まりました。

先読み幅を変えて測った結果です。

lookahead ≒遅延 処理時間 median P95
0 80ms 11.8ms 12.2ms
3 320ms 12.8ms 14.2ms
13 1120ms 16.0ms 19.2ms

80ms しか先を見ていない設定でも、日本語の転写は句点が1つ落ちる程度でした。チャンクあたり 12〜19ms なので、1チャンクの予算 150ms に対して十分軽い数字です。VRAM はロード時 2.596GB、ピーク 5.15GB(fp32)でした。

論文が書いていない部分を決める

LLM Adapter は論文の指定どおり4層の Transformer Encoder です。

layer = nn.TransformerEncoderLayer(
    d_model=1024, nhead=8, dim_feedforward=2048,
    dropout=0.1, batch_first=True, activation="gelu", norm_first=True)

ffn_dim を 2048 にしたのはパラメータ数を論文の記述(約34M)に合わせるためで、4096 だと 50M になります。位置エンコードは学習可能なパラメータにしました。cache-aware streaming ではチャンクの長さが可変で、hidden の時間方向の長さが 1 にも 4 にもなるためです。

Acoustic Adapter は「4層 Transformer」としか書かれていないので、LLM Adapter と同型のものを再利用しています。問題はその先で、時間方向に長さのある音響系列と、固定長の LLM last-hidden をどう混ぜるかが論文にありません。決めたのは2点です。

  1. 音響系列は masked-mean で時間方向に潰して固定長にする
  2. LLM hidden と連結してから線形射影する

加算にしなかったのは次元を揃える制約が強いからで、連結なら音響と意味の寄与を層が学習できます。

あとから別方式も試せるよう切り替え式にしましたが、そうすると新しい問題が出ます。どの方式で学習したかが checkpoint から分からないと、推論時に別の計算をしてしまいます。そこで構成キーを checkpoint 自体に書き込み、復元は必ずその値を通すようにしました。load_state_dict は strict のままなので、取り違えるとキーの過不足で必ず落ちます。静かに別のモデルになりません。

Turn Detector は指定どおり3層の MLP です。

self.net = nn.Sequential(
    nn.Linear(1024, 512), nn.GELU(), nn.Dropout(0.1),
    nn.Linear(512, 512),  nn.GELU(), nn.Dropout(0.1),
    nn.Linear(512, 4),
)

Cascaded と Semantic は LLM が状態トークンを生成してその logit から確率を出しますが、Unified はこの4つの logit を softmax します。

学習データを作る

論文の学習は4段階です。省いたのは1段階目の ASR 事前学習だけで、あとは実施しました。

段階 設定
Modality Alignment(Adapter を ASR 目的で) epochs 2 / batch 16 / lr 5e-4
Joint(Adapter と LLM をターンデータで) epochs 3 / batch 8 / lr 2e-5 / prompt dropout 0.35
Fusion(Acoustic Adapter と Turn Detector) epochs 6 / batch 8 / lr 1e-4

データ側で効いたのは3点です。句読点を落とすこと、クラス分布を揃えること、実会話データを混ぜることです。

句読点を落とす

合成テキストで4状態データを作ると、句読点が完結と未完結を分ける手がかりになります。実会話の書き起こしには句読点が無いため、そのまま学習したモデルは実会話で判別できません(合成テキストでの Macro-F1 0.864 に対し、実会話では 0.450)。

平均長 句読点を含む割合
学習(合成) 13.4字 18.7%
実会話の書き起こし 12.7字 0.0%

テキスト生成の段階で句読点を落とすか、実会話の表記に寄せます。

ASR を経由する構成では、転写の際に元テキストの句読点が失われるため、この影響は小さくなります(C/I Youden J はテキスト直渡しの 0.380 に対し、ASR 経由で 0.460)。

クラス分布を揃える

音声経路を新しく学習させる場合、学習データ中の比率が小さいクラスは学習されません。相槌が 400件中4件(1%)の構成では、評価時に相槌を一件も予測しませんでした。

4状態をおおむね均等にした 1825件(complete 650 / incomplete 675 / backchannel 250 / wait 250、相槌 13.7%)で学習すると回復します。

指標 相槌 1% 相槌 13.7%
相槌 F1 0.000 0.916
Macro-F1 0.282 0.552

学習の前にクラス分布を数え、単一クラスが 5% を切っていたら止めるようにしています。

実会話データを混ぜる

台本から作った合成音声だけで学習すると、実音声での C/I 判別が伸びません。実会話コーパス(J-CHAT)から 1841件を足し、エンコーダは凍結したまま Adapter と判定側だけを再学習しました。

条件 追加前 追加後 差
clean +0.140 +0.380 +0.240
雑音 snr10 −0.080 +0.120 +0.200
重なり +0.020 +0.060 +0.040

5条件すべてで同じ方向に動きます。実会話の incomplete は、文法的には完結して聞こえるものが多く(語尾に「けどね」が付いているだけで話が続くなど)、台本から作ったデータにはこの形があまり入っていません。

ただし J-CHAT は wait と相槌が乏しいので、混ぜると学習データの構成が偏ります。クラス頻度の逆数で重みを付けると(実測で 0.291 / 0.287 / 1.611 / 1.811)wait の取りこぼしは 0.680 から 0.820 に戻ります。相槌は戻りません。クラス重みは比率の偏りを補正できますが、絶対数の不足(281件)は補正できません。

効かなかった介入

complete の判定は 0.589 で頭打ちになり、ここから先は動きませんでした。原因の切り分けとして、誤りのない書き起こしをそのまま与えた条件を測ってあります。

与えたテキスト complete F1 相槌 F1
ASR の出力 0.5895 0.727
正解の書き起こし 0.5934(p=1.0) 0.923(p=0.0018)

complete の頭打ちはテキスト由来ではないので、ASR を差し替えても上がりません。一方で相槌は大きく上がるため、ASR の改善は相槌の判定に効きます。

ほかに試して効果が無かったものです。

  • 学習データに無い末尾パターン(倒置・接続助詞終わりの complete)を257件生成して置換 → complete F1 0.589 → 0.422
  • 直前の発話を文脈として与える(3手法)→ 改善なし。正解を与えるオラクル条件でも −0.056
  • 発話末尾だけをプーリング → −0.007(全体の平均が既に AUC 0.894)
  • 重み平均(SWA)→ 標準偏差 0.0555 → 0.0526(F=1.11)で誤差内

評価

評価セットと測り方

比較の下限に VAD-only、参照上限に前回の exp11a を置き、評価セットは exp11a に合わせました。complete / incomplete / 相槌が各50件(exp11a と同一の実 TalkBank 音声、電話品質)、wait は実会話に出てこないので合成で50件。これを clean・雑音2段階・重なり・雑音と重なりの5条件に展開しています。

読み込み時にスキーマ検証を挟み、ラベル分布・正解テキストの切り詰め・音声ファイルの解決・学習データとの重複を機械的に確認します。最後の1つはコミット前のフックにも入れました。GPU 上で書いた変換スクリプトが正解ラベルを一律 complete に固定していたことがあり、人間の注意に頼らない形にしてあります。

遅延は end-to-end で エンコーダ 59.6ms + 判定器 50.6ms = P95 110.2ms。GPU 計測なので前後に torch.cuda.synchronize() が要ります。ASR の最終文字列をチャンク数で等分割して途中経過を作る方式は、時刻がデコードに対応しないため測定になりません(150件中 87件が 0.0、63件が null になります)。

測れる差の大きさ

比べたい差を、この測定系が見分けられるか。学習側の揺れと、評価セット側の分解能の両方を先に測ります。

まず学習の揺れです。構成もデータもハイパーパラメータも変えず、乱数の種だけを変えて12回学習しました。

指標 12回の平均 標準偏差
Macro-F1 0.6664 0.0510
相槌 F1 0.6461 0.1143

分散を減らす手として効いたのは学習率スケジュールでした。cosine の減衰でエポックを12に増やすと標準偏差が 0.0555 → 0.0293(−47%、F=3.59、p=0.022)、平均は下がりません。相槌も 0.1675 → 0.0863 と半減します。この条件で Unified と Semantic を12回ずつ比べました。

条件 差 標準誤差 z
1回対1回(最初の公表値) +0.079 — —
12回ずつ +0.0306 0.0218 +1.41
分散を減らしてから12回ずつ +0.0190 0.0152 +1.25

判定の境界は z が 2 以上なので、音響融合の優位は未検証としました。符号は2条件とも正で、否定されたわけではありません。相槌の誤り方を見ると Semantic の 50件中30件が incomplete に流れていたのが Unified では10件に減っており、韻律を入れた効果そのものは観測できています。

分散があっても大きい差は検出できます。同じ12回で、末尾パターン生成の失敗(−0.167)は +3.98σ と明確に出ました。1回対1回の比較が意味を持つのは、この規模からです。

次に評価セット側です。200件でどれくらいの差を検出できるのかを、層別ブートストラップ 4000回で測ります。

指標 実測 95% 信頼区間 閾値
Macro-F1 0.718 [0.655, 0.775] 0.75
C/I Youden J 0.440 [0.260, 0.600] 0.40
complete F1 0.589 [0.465, 0.695] 0.65

信頼区間が閾値をまたぐので、通っているように見える項目も決着していません。必要な件数は Macro-F1 で約700件、C/I Youden J で約1800件でした。

評価セット自体の質も6種類で検査しました。判定器の出力を見る前に、単純な特徴量だけで当てられないかを確かめるものです。

  • wait とドメインが 100% 交絡。5〜8kHz の帯域だけで分離でき AUC 0.999(合成で足した wait を音質で当てられる)
  • 相槌50件は音声長 1.08秒の単一閾値に負ける(判定器 0.742 に対し 0.860)
  • 相槌の異なり表層形が7種しかない。86% が「うん」
  • 誤切断の対象100件のうち50件は、無音が最大 0.400秒で閾値 0.550秒では発火しない

このうち3点はモデルを改善しても動きません。参照上限の exp11a 自身が complete F1 0.6415 で閾値 0.65 に届いていないことも、ここで分かりました。この検査を先に通すと、モデル側の伸びしろと物差し側の欠陥を切り分けられます。

まとめ

  • 論文どおりの系統の序列(VAD-only < Cascaded < Semantic < Unified)と、エンコーダ込み P95 110.2ms は再現できました
  • 精度は前世代のモデル(0.810)に 0.718 で届いていません
  • 音響融合の優位は、12回ずつ測ると z=+1.25 で検証できていません

参考