はじめに
日本語の TTS(音声合成)、特に OpenJTalk のような G2P(辞書)ベースの方式 を使っていて一番困るのが、固有名詞や新語の 誤読 です。Hugging Face がぎこちなく区切られたり、潤羽るしあ のような VTuber 名がまったく違う音で読まれたり。辞書に無い語はそのまま事故になりますが、今は「合成して耳で聞いてはじめて気づく」後手対応しかありません。
これを 合成する前に「ここが事故りそう」と一覧で出す モデルを作りました。 yomi-linter という名前で、入力した日本語文から TTS が誤読しそうな固有名詞・未知語のスパンを返します。
例 A: 技術記事の事前チェック(英字固有名詞混在)
uv run python scripts/lint.py --quantize --format text \
  "PyTorch で学習した LangChain アプリを Anthropic に繋いだ"
検出 3件:
  ⚠ PyTorch    (0-7)    score 1.0
  ⚠ LangChain  (13-23)  score 1.0
  ⚠ Anthropic  (28-38)  score 1.0
例 B: 漢字専門語(医療)
uv run python scripts/lint.py --quantize --format text \
  "蜂窩織炎の症状が出た患者に冠動脈瘤の検査も実施した"
検出 2件:
  ⚠ 蜂窩織炎の  (0-5)    score 0.974
  ⚠ 瘤          (16-17)  score 0.916
蜂窩織炎 は OpenJTalk が「ハチ窩織エン」と誤読する語で、これを正確に検出できています。冠動脈瘤 は「瘤」だけ拾って熟語全体を取れていません(既知の取りこぼし)。
例 C: ニッチ固有名詞(辞書では絶対に拾えない)
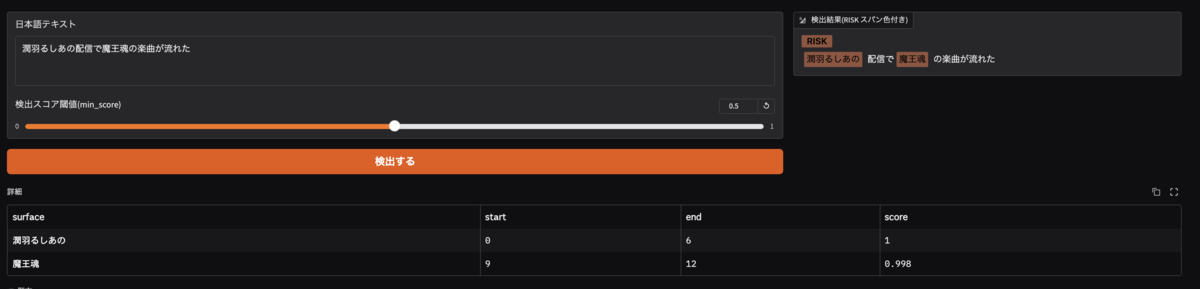
uv run python scripts/lint.py --quantize "潤羽るしあの配信で魔王魂の楽曲が流れた"
[
  {"surface": "潤羽るしあの", "start": 0, "end": 6, "label": "RISK", "score": 1.0},
  {"surface": "魔王魂", "start": 9, "end": 12, "label": "RISK", "score": 0.999}
]
VTuber 名 潤羽るしあ とフリー BGM レーベル 魔王魂。どちらも汎用的な読み辞書には載っていませんが、しっかり検出できています。
demo
hugginfaceのspaceでデモを公開しています
モデルは以下で公開しています
背景
「固有名詞の読みなら辞書を引けば済むのでは?」という発想は自然です。実際、日本語の読み辞書として有名な JmnedictFurigana + JmdictFurigana を合わせると 82 万語あります。
ところが、これを筆者のブログコーパスにぶつけて検証したところ、自分のニッチ語彙の 2% しかカバーできない という結果でした。VTuber 名、新興サービス名、技術略語、人物名 ― そのほとんどが 82 万語には載っていません。
辞書を諦めると、次の選択肢はモデルです。日本語の固有名詞・未知語を文脈から検出するために、軽量で日本語専用にチューニングされている ModernBERT-Ja(MIT)をベースに選びました。130m / 70m / 30m のサイズが公開されていて、用途で選び分けができる点も決め手です。
データセットの作成
固有表現抽出(NER)のモデルを fine-tune するには、ラベル付きデータが必要です。ここで人手アノテーションを始めるとコストが青天井になるので、学習データは全部自動生成する 方針にしました。
データ源は 2 系統です。
①辞書ミス抽出(LLM 不要) ― MeCab(UniDic)と pyopenjtalk の両方で形態素解析・読み付与をかけて、読みが一致しない語 を集めます。これだけで「OpenJTalk が読み間違える語」が無料で取れます。
②固有名詞 NER ― 文中の固有名詞スパンは LLM で合成データを作成しました。
①と②を BIO 整列して、自分のブログ + Wikipedia NER データセット を結合して学習データに使います。Wikipedia を加えることで、作者のニッチ語彙を保持したまま、汎用的な日本語の固有名詞にも汎化させられます。
学習
最初に学習したモデル(=「漢字弱ラベル注入前」)は 蜂窩織炎 のような漢字熟語を取りこぼしがちでした。そこで UniDic と OpenJTalk の読みが食い違う漢字熟語を抽出して codex で監査し、真の誤読語 118 個をキャリア文 107 文に注入して追加学習。こうしてできたのが本記事の最終モデル(=「漢字弱ラベル注入後」)です。
評価
OpenJTalk が実際に誤読する固有名詞・専門語を、モデルが合成前に拾えた割合(recall)で比較しました。
| 比較対象 | 純日本語固有名詞 | 漢字専門語(医療含む) |
|---|---|---|
| OpenJTalk + 読み辞書のみ | 14% | ― |
| モデル(漢字弱ラベル注入前) | 71-100% | 47% |
| モデル(漢字弱ラベル注入後・本記事) | 71-100% | 82% |
漢字弱ラベル注入で、特に医療ドメインの recall は 0/6 → 5/6 まで改善しました。
