初めに
聞きながら話せる音声対話モデル Haru-4B を、Windows と uv で動かしてみました。RTX 4070 Ti SUPER でブラウザから会話を始められたので、環境構築の手順と、動かして分かったことをまとめます。
Haru-4B とは
Haru-4B は日本語を含む9言語に対応した全二重の音声対話モデルで、音声を受け取りながら自分の音声とテキストを生成します。
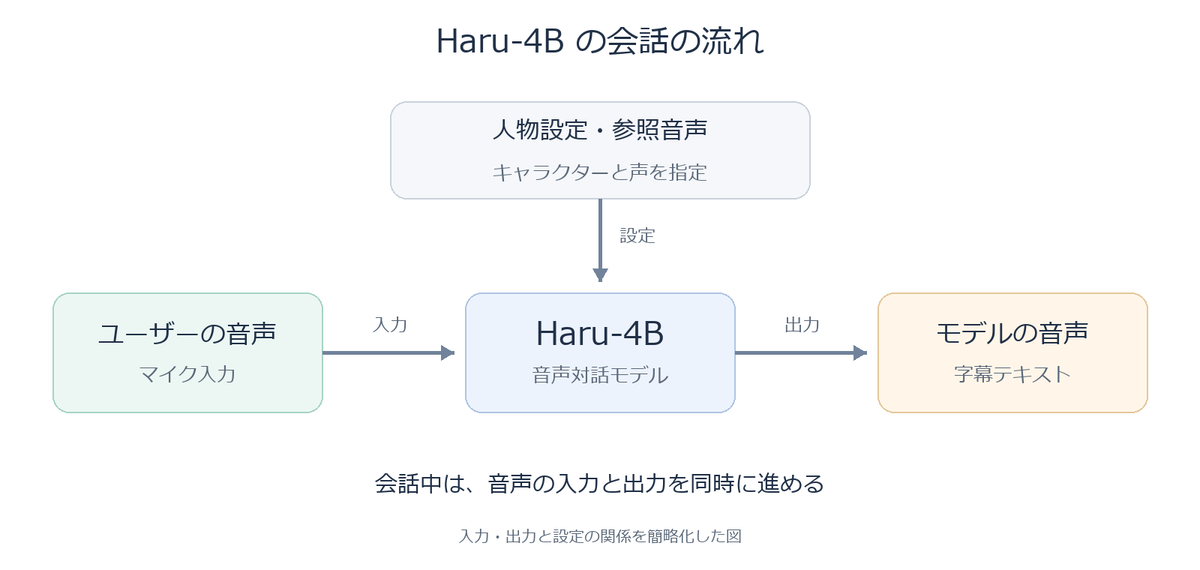
人物設定はテキスト、声は短い参照音声で指定でき、追加学習なしで試せる仕組みです。モデルの詳しい構成は公式の日本語解説を参照してください。
開発環境
| 項目 | 環境 |
|---|---|
| OS | Windows 11 Education 23H2 |
| GPU | RTX 4070 Ti SUPER、16 GB |
| メモリ | 約64 GiB |
| Python / uv | 3.12.13 / 0.12.20 |
| PyTorch | 2.11.0+cu128 |
| Transformers | 5.23.0 |
| haru-speech | 0.1.1 |
環境構築
Git、uv、NVIDIA ドライバーを用意し、PowerShell から公式リポジトリを取得します。
git clone https://github.com/higurashi-ai/Haru.git
cd Haru
git checkout 7fe6b7665f8bf035998f401f8cb779fbe53f2751

uv init --bare --name haru-local --python 3.12 --no-workspace
uv python pin 3.12
リポジトリ直下にできた pyproject.toml を次の内容に変更し、Windows x64 と CUDA 12.8 の環境を指定します。
[project]
name = "haru-local"
version = "0.1.0"
requires-python = ">=3.12,<3.13"
dependencies = []

[tool.uv]
package = false
environments = ["sys_platform == 'win32' and platform_machine == 'AMD64'"]

[[tool.uv.index]]
name = "pytorch-cu128"
url = "https://download.pytorch.org/whl/cu128"
explicit = true
続けて Haru と CUDA 版 PyTorch を登録します。--no-sync で依存関係の登録を先に済ませ、最後にまとめてインストールしています。
uv add --no-sync --no-workspace ./haru
uv add --no-sync "torch==2.11.0+cu128" --index pytorch-cu128=https://download.pytorch.org/whl/cu128
uv add --no-sync "transformers==5.23.0"
uv sync --locked
explicit = true により、指定した PyTorch だけが CUDA 用のインデックスを参照する形になります。生成された uv.lock を残しておけば、次回からも uv sync --locked で環境を復元できます。
CUDA の確認は次のコマンドで行いました。
uv run python -c "import torch; assert torch.cuda.is_available(); print(torch.__version__); print(torch.cuda.get_device_name(0))"
起動して会話する
同じ PC のブラウザから使うので、通信は WebSocket、コーデックは PyTorch の実装にして起動します。
uv run haru-server --device cuda --language ja --network-profile local --codec-backend torch --webrtc off
初回は約10.5 GBのモデルを取得するため、手元ではダウンロードを含む読み込みに203.2秒かかりました。ログに haru.server: ready が出たら http://localhost:8998 を開きます。
- 「キャラクター」で言語を日本語にし、人物設定を選ぶ
- 下へスクロールし、「声」→「ファイル」→「ファイルを選択…」から音声を入れる
- 「会話を始める」を押し、マイクの使用を許可する
声は同梱されていないので、利用する権利のある3秒〜3分の WAV/FLAC を用意します。1人の話者で雑音が少なく、無音を除いて3秒以上あるものが必要です。
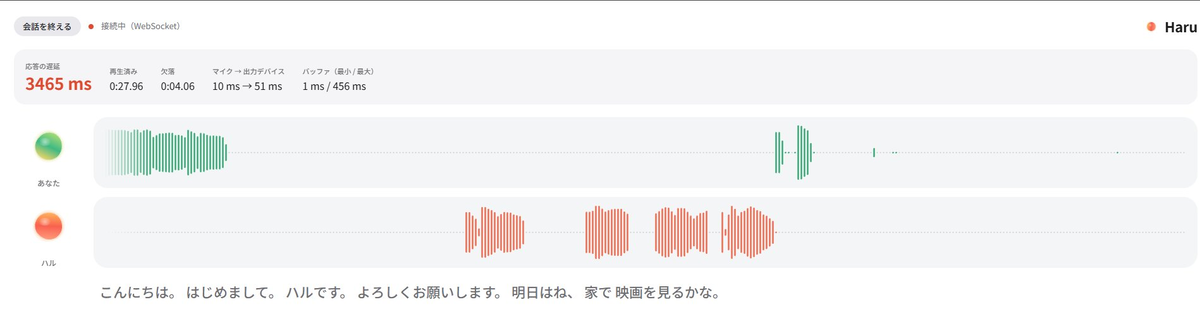
実行結果
起動時のウォームアップでは、16フレームの処理時間の中央値が135.7 msでした。音声1フレームの約133.3 msを少し上回っており、会話中の推定遅延も次のように増えていきました。
| 会話開始から | 中央値(p50) | p95 |
|---|---|---|
| 約10秒 | 746 ms | 1,174 ms |
| 約60秒 | 3,217 ms | 5,612 ms |
| 約100秒 | 5,260 ms | 10,848 ms |
この表はブラウザの平滑化された遅延表示の累積統計で、質問ごとの応答時間を直接測ったものではありません。起動と会話開始はできたものの、今回の構成では遅れが蓄積する状態でした。
causal_conv1d と flash-linear-attention がなく、言語モデル側が PyTorch の参照実装へフォールバックする警告も出ていました
ハマったところ
環境構築と音声の読み込みで確認した点をまとめます。
| 起きたこと | 対応 |
|---|---|
| 編集可能インストールで import に失敗 | --editable を使わず、通常のローカルパス依存で登録 |
録音の読み込み処理で Permission denied |
Windows の一時ファイル共有制限を、WAV/FLAC のアップロードで回避 |
録音の読み込み処理自体は未修正です。また、最初のモデル取得は Xet の転送で停滞したため、サーバーを止めてから同じ PowerShell で次を設定し、起動し直しています。
$env:HF_HUB_DISABLE_XET = "1"
これで Xet クライアントを使わない HTTPS ダウンロードが完了しました。設定は現在の PowerShell と、そこから起動するプロセスに適用されます。
